- Hemos viajado a San Francisco para conocer NVIDIA RTX Spark: así es la mayor revolución del PC en años
- ASUS ProArt P16 H7607, análisis: NVIDIA RTX Spark llega a Windows para cambiar las reglas del juego
La nueva plataforma RTX Spark de NVIDIA no está pensada únicamente para ejecutar Windows sobre un procesador ARM. Su objetivo es integrar CPU y GPU en un mismo chip, conservar el ecosistema de aceleración RTX y ofrecer una cantidad de memoria compartida especialmente útil para la inteligencia artificial. Es un planteamiento distinto al de un PC convencional, tanto por sus ventajas como por las limitaciones que supone. Y con el nuevo equipo ASUS ProArt GR1X, el fabricante de chips lleva este concepto a un nuevo nivel.
Hace poco tuvimos la oportunidad de analizar el portátil ASUS ProArt P16, uno de los primeros portátiles en estrenar la nueva plataforma NVIDIA RTX Spark. Ahora volvemos a encontrarnos con el mismo procesador, el N1X, pero en un ordenador de sobremesa que prescinde de la pantalla, la batería y el resto de los componentes de un portátil para concentrar todo el hardware en un chasis de apenas 1,15 litros.
Especificaciones técnicas
| Característica | Detalle |
|---|---|
| Modelo | ASUS ProArt GR1X |
| Plataforma | NVIDIA RTX Spark N1X · Windows 11 sobre ARM |
| CPU | NVIDIA Grace, 20 núcleos |
| GPU | NVIDIA Blackwell RTX, 6.144 núcleos CUDA |
| Cálculo de IA | Hasta 1 PFLOP en FP4, según NVIDIA |
| Memoria | Hasta 128 GB LPDDR5X unificada; configuración según versión |
| Ancho de banda | 300 GB/s de memoria; 600 GB/s NVLink-C2C para el enlace CPU-GPU |
| Almacenamiento | Dos ranuras M.2 NVMe; capacidad según configuración |
| Red | Ethernet 10 GbE, Wi-Fi 7 y Bluetooth 5.4 |
| Vídeo y conexiones | HDMI y USB-C con salida de vídeo; revisar capacidades por puerto |
| Refrigeración | Dos ventiladores centrífugos y bloque de aletas de cobre |
| Alimentación | Adaptador externo; verificar potencia en etiqueta del equipo |
| Dimensiones | 150 × 150 × 51 mm (ficha del modelo) |
| Ampliaciones | SSD: sí; RAM/SoC: no |
El ASUS ProArt GR1X es un mini PC bastante peculiar. En su interior encontramos una CPU ARM de 20 núcleos, una GPU Blackwell con 6.144 núcleos CUDA y hasta 128 GB de memoria LPDDR5X unificada. Es una configuración muy diferente a la de un mini PC tradicional, especialmente por la cantidad de memoria a la que puede acceder la gráfica y por las posibilidades que ofrece para trabajar con modelos de inteligencia artificial en local.

NVIDIA RTX Spark N1X: 20 núcleos ARM y una GPU Blackwell
El procesador que da vida al GR1X es el NVIDIA RTX Spark N1X. Estamos ante un SoC basado en arquitectura ARM, por lo que no utiliza los habituales núcleos x86 que encontramos en los procesadores Intel y AMD. En su lugar, NVIDIA ha integrado una CPU Grace de 20 núcleos que trabaja junto a una GPU Blackwell dentro del mismo conjunto.
La parte gráfica es especialmente interesante. Tenemos 6.144 núcleos CUDA, además de los correspondientes núcleos Tensor y RT que permiten acelerar las operaciones de inteligencia artificial y trazado de rayos. Sobre el papel, son los mismos núcleos CUDA que encontramos en una GeForce RTX 5070, aunque esto no significa que ambas gráficas ofrezcan el mismo rendimiento. Las frecuencias de trabajo, el consumo y, sobre todo, el sistema de memoria son diferentes.
Una de las ventajas de utilizar Blackwell es que tenemos acceso al ecosistema de NVIDIA prácticamente al completo. Podemos utilizar CUDA para acelerar aplicaciones de cálculo, OptiX en motores de renderizado compatibles y tecnologías como DLSS, Reflex o ray tracing en videojuegos. También contamos con soporte para NVFP4, un formato de precisión de cuatro bits que permite mejorar el rendimiento de determinadas cargas de inteligencia artificial y reducir la memoria que necesitan los modelos compatibles.
NVIDIA anuncia hasta 1 PFLOP de rendimiento en IA utilizando FP4. Es una cifra elevada para un ordenador de estas dimensiones, aunque debemos entenderla como una capacidad teórica de cálculo en ese formato concreto. No significa que el equipo tenga el rendimiento general de una estación de trabajo de un petaflop, ni que todas las aplicaciones de inteligencia artificial puedan alcanzar esa velocidad.
Aquí está precisamente una de las principales diferencias respecto a otros mini PC. El GR1X no depende únicamente de una CPU potente con gráficos integrados para acelerar aplicaciones. Utiliza una GPU RTX completa a nivel de tecnologías, con acceso a las herramientas que NVIDIA lleva años desarrollando para sus tarjetas gráficas.
Hasta 128 GB de memoria unificada: la verdadera ventaja del N1X
Aunque el procesador y la GPU tienen unas especificaciones bastante interesantes, creemos que la memoria es lo que realmente diferencia a RTX Spark de otras plataformas.
En un ordenador convencional, la CPU utiliza la RAM del sistema y la tarjeta gráfica tiene su propia VRAM. Si tenemos una GeForce con 16 GB de memoria y queremos ejecutar un modelo de inteligencia artificial que necesita 32 GB, no podemos cargarlo por completo en la VRAM, aunque nuestro ordenador tenga 64 o 128 GB de RAM. Existen formas de repartir la carga entre la memoria de la gráfica y la del sistema, pero suelen introducir importantes penalizaciones de rendimiento.
Con RTX Spark esto cambia. La CPU y la GPU comparten el mismo conjunto de memoria LPDDR5X, que en el ASUS GR1X puede alcanzar los 128 GB, con una velocidad de hasta 9.400 MT/s y un ancho de banda de 300 GB/s. Gracias a ello, podemos trabajar con modelos que necesitan una cantidad de memoria superior a la que encontramos en muchas tarjetas gráficas dedicadas.
Eso sí, hay algunos matices. Aunque tengamos 128 GB de memoria unificada, no significa que Windows reserve toda esa capacidad para la GPU. NVIDIA permite modificar la asignación de memoria desde NVIDIA App, y en los equipos de 128 GB establece por defecto 62,5 GB para la parte gráfica. Podemos aumentar esta reserva hasta 96 GB, pero estaremos reduciendo la cantidad disponible para el resto del sistema.
Para trabajar con aplicaciones convencionales esto no supone una ventaja demasiado importante, pero la situación cambia cuando utilizamos modelos de lenguaje grandes con Ollama, llama.cpp o LM Studio, o cuando cargamos proyectos complejos de generación de imágenes y vídeo en ComfyUI.
Podemos tener más memoria disponible para alojar los modelos sin necesidad de instalar varias tarjetas gráficas, aunque el rendimiento dependerá del modelo, su cuantización y la velocidad del subsistema de memoria. No debemos confundir disponer de mucha memoria con tener necesariamente una GPU más rápida.
También debemos tener presente que la memoria está integrada en la placa y no podemos ampliarla. ASUS ofrece configuraciones de 64 y 128 GB, así que conviene elegir bien desde el principio. Para utilizar Windows, trabajar con aplicaciones creativas y ejecutar modelos pequeños, 64 GB pueden ser suficientes, mientras que la versión de 128 GB resulta mucho más interesante cuando queremos trabajar con modelos de mayor tamaño o contextos especialmente largos.
Almacenamiento y conectividad
En cuanto al almacenamiento, ASUS ha incluido dos ranuras M.2 NVMe, una compatible con PCIe 5.0 y otra con PCIe 4.0. Según la configuración, podemos encontrar el equipo con unidades de hasta 4 TB, una capacidad razonable para un ordenador de este tipo, aunque la posibilidad de instalar un segundo SSD nos parece especialmente útil.
Si vamos a trabajar con IA local, no tardaremos demasiado en llenar el almacenamiento. Entre los modelos de lenguaje, sus distintas cuantizaciones, modelos de generación de imágenes y archivos de trabajo, es bastante sencillo acumular varios cientos de gigabytes. Poder dedicar una unidad exclusivamente a estos contenidos y mantener el sistema operativo en otra es una opción que agradecemos.
En conectividad de red, el GR1X está bastante bien equipado. Tenemos Wi-Fi 7 con configuración 2×2, Bluetooth 5.4 y, algo que no siempre encontramos en mini PC, un puerto Ethernet de 10 Gb. Este último puede venirnos especialmente bien si trabajamos con grandes archivos de vídeo, proyectos 3D o modelos almacenados en un NAS, siempre que el resto de nuestra red también soporte estas velocidades.
Las conexiones físicas son algo más particulares. ASUS ha apostado por tres puertos USB-C 3.2 Gen 2×2, con velocidades de hasta 20 Gbps y soporte para salida de vídeo mediante DisplayPort Alt Mode. También tenemos HDMI 2.1 y otro USB-C dedicado a la alimentación, compatible con USB Power Delivery 3.1 EPR.
Esta distribución permite conectar hasta cuatro pantallas, algo interesante para un equipo de trabajo. Sin embargo, también encontramos una ausencia bastante llamativa: no tenemos ningún puerto USB-A. Si utilizamos periféricos tradicionales, memorias USB o determinados accesorios, necesitaremos recurrir a adaptadores o a un hub.
Windows 11 sobre ARM: cada vez mejor, pero todavía con limitaciones
Por último, tenemos el sistema operativo. El ASUS GR1X llega con Windows 11 para ARM, por lo que podemos utilizar una experiencia de escritorio prácticamente idéntica a la de cualquier otro PC con Windows. Sin embargo, por debajo hay diferencias importantes.
Las aplicaciones desarrolladas específicamente para ARM64 funcionan de forma nativa, mientras que muchos programas x86 y x64 dependen de Prism, el sistema de emulación de Microsoft. En los últimos meses hemos visto avances importantes en compatibilidad, especialmente en software creativo, herramientas de desarrollo y videojuegos, pero todavía hay aplicaciones que pueden dar problemas.
Nosotros mismos lo comprobamos con el ASUS ProArt P16, donde algunas herramientas de diagnóstico no funcionaban correctamente. NVIDIA sigue recomendando utilizar su versión ARM64 de FrameView para monitorizar el rendimiento, mientras trabaja con los desarrolladores de otras aplicaciones para resolver las incompatibilidades.
También debemos tener cuidado con determinados videojuegos multijugador, especialmente aquellos que utilizan sistemas antitrampas que necesitan soporte específico para ARM. NVIDIA está ampliando la lista de soluciones compatibles, pero eso no significa que todos los juegos funcionen automáticamente.
En cualquier caso, el GR1X no está planteado únicamente como un ordenador para jugar. Su combinación de CPU Grace, GPU Blackwell y memoria unificada tiene mucho más sentido para quien necesite trabajar con aplicaciones profesionales, renderizado o inteligencia artificial en local. Y aquí es donde este pequeño equipo puede ofrecer algo diferente a un mini PC convencional.
Análisis externo del ASUS ProArt GR1X
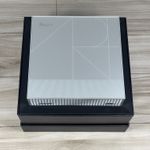
Vamos a comenzar con el análisis del ASUS ProArt GR1X, que nos llega en una caja de cartón negra con el diseño habitual de los productos de esta familia. En la parte superior encontramos el logotipo ProArt, acompañado de unas líneas geométricas bastante discretas, mientras que en los laterales tenemos el nombre del modelo, el logotipo de ASUS y el distintivo verde de NVIDIA RTX Spark. No hay fotografías del ordenador ni demasiada información sobre sus características, algo que tampoco echamos en falta teniendo en cuenta el tipo de producto que tenemos entre manos.


Al abrir la caja nos encontramos directamente con el mini PC, colocado dentro de un alojamiento de protección y envuelto para evitar arañazos durante el transporte. El embalaje aprovecha bastante bien el espacio, algo lógico teniendo en cuenta que el propio ordenador es muy pequeño. Una vez retiramos el equipo, podemos acceder al compartimento inferior donde ASUS ha colocado los accesorios.

Aquí encontramos el adaptador de alimentación externo, su correspondiente cable para conectarlo a la corriente y la documentación del producto, incluyendo la información de seguridad y garantía. No tenemos demasiados accesorios adicionales, aunque tampoco son necesarios para poner en marcha el ordenador. Solo tendremos que conectar la alimentación, un monitor y nuestros periféricos.

El adaptador de corriente es bastante más grande de lo que podríamos esperar viendo las dimensiones del GR1X. Se trata de una fuente externa de 240 W, con el habitual formato rectangular que encontramos en muchos portátiles de alto rendimiento. No llega a ser un problema, pero sí debemos tenerlo en cuenta si queremos montar un escritorio especialmente despejado. El ordenador ocupa muy poco, aunque tendremos que buscar dónde colocar el transformador y recoger los cables.


Una vez sacamos el GR1X de su embalaje, lo primero que llama la atención es su tamaño. Estamos hablando de un ordenador de apenas 150 × 150 milímetros, con una altura de 51 milímetros. Para hacernos una idea, ocupa aproximadamente el mismo espacio que otros mini PC compactos, pero con un hardware mucho más ambicioso en su interior. Podemos colocarlo debajo del monitor, en una esquina de la mesa o junto a cualquier otro periférico sin que apenas nos quite sitio.

Eso sí, al cogerlo sorprende su peso. ASUS declara 1,48 kg, una cifra bastante considerable para un equipo tan pequeño. El chasis transmite una buena sensación de solidez y no encontramos holguras ni piezas que se muevan al manipularlo. Su construcción está a la altura de lo que esperamos de un producto de la familia ProArt.
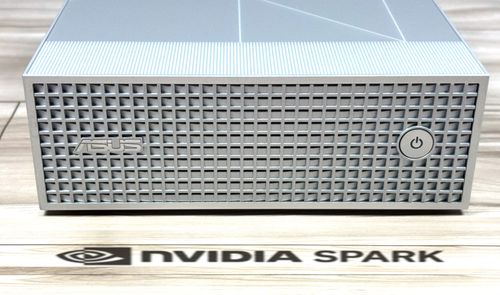
En cuanto al diseño, ASUS ha optado por un acabado plateado, sin iluminación RGB ni elementos especialmente llamativos. La parte superior está decorada con un patrón de líneas geométricas que dividen la superficie en varias secciones, incluyendo una figura circular integrada en el dibujo. El resultado es bastante elegante, con un aspecto más cercano al de un equipo profesional que al de un mini PC gaming.
En una de las esquinas tenemos el logotipo ProArt, también bastante discreto. La superficie superior es completamente plana, sin botones ni conectores, y queda interrumpida únicamente por las aberturas de ventilación que encontramos cerca de uno de los bordes.
Si miramos el frontal, encontramos una de las partes más características de este ordenador. ASUS ha utilizado una gran rejilla formada por pequeñas aberturas cuadradas que ocupa prácticamente toda la superficie. Esta rejilla permite la circulación del aire hacia el interior y, además, le da un aspecto bastante particular al equipo.

En el extremo derecho tenemos el botón de encendido, perfectamente integrado en la propia rejilla. Es pequeño y apenas destaca sobre el resto del frontal, aunque se identifica fácilmente gracias al símbolo de encendido. No encontramos conexiones USB ni ningún otro elemento adicional en esta zona.
Aquí tenemos una de las primeras decisiones de diseño que no nos terminan de convencer. En un ordenador de sobremesa, aunque sea tan pequeño, siempre viene bien tener al menos un puerto USB accesible desde el frontal para conectar una memoria, un receptor inalámbrico o cualquier otro dispositivo temporal. ASUS ha preferido dejar toda la conectividad en la parte posterior para mantener el frontal despejado.
Los dos laterales son mucho más sencillos. Tenemos superficies completamente lisas, con el mismo acabado plateado y sin aberturas de ventilación. Los bordes están ligeramente redondeados y las uniones entre las diferentes piezas del chasis quedan bastante bien disimuladas. Es un diseño que apuesta claramente por la sencillez, sin adornos innecesarios.


La parte posterior es donde encontramos todas las conexiones. Lo primero que vemos es una gran rejilla de ventilación con aberturas verticales, bastante más grandes que las del frontal. Ocupa prácticamente toda la anchura del equipo y tiene una función importante, ya que permite expulsar el aire caliente generado por el sistema de refrigeración.

Debajo de esta rejilla ASUS ha colocado los puertos de conexión. Empezando por la izquierda encontramos la ranura de seguridad Kensington y el USB-C dedicado a la alimentación. Este último está identificado con un símbolo de corriente y utiliza USB Power Delivery, por lo que no debemos confundirlo con los otros tres USB-C de datos que tenemos a su derecha.
Estos tres puertos USB-C son compatibles con USB 3.2 Gen 2×2, con velocidades de hasta 20 Gbps, y también permiten utilizar DisplayPort Alt Mode para conectar monitores. ASUS ha marcado esta función directamente en el chasis, algo que agradecemos porque facilita identificar qué conectores podemos utilizar para sacar vídeo.
A continuación tenemos la salida HDMI 2.1 y, finalmente, el puerto Ethernet de 10 Gb. Este último nos parece especialmente interesante, ya que no es habitual encontrar una conexión de red de esta velocidad en un mini PC. Si trabajamos con archivos grandes almacenados en un NAS o tenemos una infraestructura de red preparada para 10 Gb, podremos aprovechar una velocidad de transferencia muy superior a la del habitual Gigabit Ethernet.
En general, la conectividad está bastante bien resuelta para el espacio disponible, aunque echamos en falta algún USB-A tradicional. ASUS ha apostado exclusivamente por USB-C, por lo que tendremos que utilizar adaptadores o un hub para conectar determinados periféricos. Tampoco encontramos una salida analógica de audio de 3,5 mm, otra ausencia que conviene tener presente.
Dándole la vuelta al ordenador encontramos la base, con cuatro pequeñas patas de goma situadas en las esquinas. Estas permiten apoyar el GR1X sobre la mesa sin que se deslice fácilmente y dejan una ligera separación respecto a la superficie.

En esta zona también tenemos las etiquetas identificativas del producto, con su información reglamentaria, y una gran rejilla de ventilación que ocupa aproximadamente la mitad de la base. Como veremos al abrir el ordenador, el sistema de refrigeración necesita aprovechar buena parte de las superficies disponibles para mantener el flujo de aire.
Por último, merece la pena destacar que ASUS ha conseguido mantener un diseño bastante limpio a pesar de las necesidades de refrigeración del hardware. No tenemos grandes protuberancias ni elementos externos que rompan la estética del equipo, y las rejillas están integradas en el propio chasis.
En conjunto, el ASUS ProArt GR1X nos ha dejado buenas impresiones en este primer contacto. Es un ordenador pequeño, bien construido y con unos acabados cuidados. La distribución de las conexiones y la ausencia de USB-A son probablemente los aspectos que menos nos han gustado, pero por lo demás ASUS ha aprovechado bastante bien el espacio disponible. Ahora vamos a abrirlo para comprobar cómo ha conseguido introducir el RTX Spark N1X y su sistema de refrigeración en un chasis tan reducido.
Análisis interno del ASUS ProArt GR1X
Después de ver lo pequeño que es este ordenador, teníamos bastante curiosidad por comprobar cómo había conseguido ASUS meter un NVIDIA RTX Spark N1X y, sobre todo, cómo había resuelto su refrigeración. Recordemos que estamos hablando de un procesador con 20 núcleos de CPU y una GPU Blackwell de 6.144 núcleos CUDA, todo ello dentro de una caja de apenas cinco centímetros de altura. Y aunque el consumo es muy inferior al de un sobremesa equipado con una tarjeta gráfica dedicada de gama alta, el calor sigue teniendo que salir de alguna manera.
Para acceder al interior tenemos que darle la vuelta al GR1X y retirar la tapa inferior. Una vez quitada, nos encontramos con una cubierta metálica negra que protege buena parte de los componentes internos y que también está sujeta mediante varios tornillos. ASUS ha aprovechado prácticamente toda la superficie disponible, por lo que no encontramos los grandes espacios vacíos que solemos ver en otros mini PC.

Esta cubierta interior también dificulta un poco el acceso a los componentes. No estamos ante uno de esos equipos en los que basta con retirar cuatro tornillos para encontrarnos directamente con la memoria y el SSD. Aquí tenemos una construcción bastante más integrada, con diferentes piezas superpuestas y parte del cableado situado junto a los bordes del chasis.
Al continuar con el desmontaje y acceder al conjunto principal, nos encontramos con lo más interesante del GR1X: su sistema de refrigeración. ASUS ha utilizado dos ventiladores de tipo turbina, colocados uno junto al otro, que trabajan con un enorme bloque de aletas de cobre. En realidad, teniendo en cuenta las dimensiones del ordenador, buena parte del espacio interno está dedicado exclusivamente a mantener controlada la temperatura del procesador.
Los ventiladores tienen un diseño centrífugo, similar al que encontramos en muchos portátiles gaming. En lugar de impulsar el aire perpendicularmente hacia la placa, como haría un ventilador convencional, lo recogen por su zona central y lo conducen hacia los laterales a través de una carcasa cerrada. Esto permite dirigir el flujo de aire hacia el disipador y, desde ahí, expulsar el calor fuera del equipo.

ASUS ha utilizado dos unidades independientes, cada una con su correspondiente motor y cableado. Es una solución bastante lógica para este formato, ya que permite aprovechar mejor la anchura disponible y repartir el flujo de aire a través de un disipador que ocupa prácticamente todo uno de los lados del ordenador.
El bloque de refrigeración también merece que nos detengamos un momento. En las fotografías podemos apreciar una gran estructura de cobre formada por numerosas aletas muy próximas entre sí. También encontramos una segunda zona de aletas con acabado negro, situada junto al borde donde están los conectores traseros. Todo el conjunto forma una pieza bastante voluminosa en comparación con el resto de los componentes.
El cobre tiene una conductividad térmica elevada, y utilizar numerosas aletas permite aumentar la superficie de intercambio de calor sin tener que recurrir a un disipador especialmente alto. Eso sí, este tipo de diseño necesita un flujo de aire suficiente para funcionar correctamente, ya que las aletas están muy juntas y ofrecen cierta resistencia al paso del aire. Precisamente por eso ASUS ha recurrido a ventiladores de turbina en lugar de otros modelos más convencionales.
En la superficie del bloque de cobre también podemos distinguir varias almohadillas térmicas, colocadas en diferentes posiciones y con distintos tamaños. Estas sirven para establecer contacto térmico con los componentes previstos en el diseño del conjunto, aunque en las fotografías no podemos identificar con seguridad todos los chips sobre los que apoyan. No hemos llegado a separar completamente el disipador del SoC, por lo que tampoco podemos ver directamente el N1X ni comprobar el material térmico empleado sobre su superficie.
Una vez tenemos el conjunto fuera, se aprecia mucho mejor lo compacta que es la placa base. ASUS ha diseñado prácticamente todo alrededor del procesador, evitando componentes que aumentarían considerablemente el tamaño, como módulos de memoria convencionales o una tarjeta gráfica independiente.
Los 64 o 128 GB de memoria LPDDR5X, dependiendo de la versión, forman parte de esta integración. No encontramos ranuras SO-DIMM, por lo que no podremos ampliar la memoria posteriormente. Es una de las contrapartidas de utilizar un sistema de memoria unificada como el del RTX Spark, aunque también es lo que permite conseguir unas dimensiones tan reducidas.
En cuanto al almacenamiento, podemos encontrar una ranura de fácil acceso para instalar un SSD M.2 quitando una tapa. La cual, además, viene con su respectivo thermal pad para ayudar a reducir la temperatura del SSD.

Una cosa que nos ha gustado de la construcción es que, a pesar del poco espacio disponible, ASUS ha utilizado una estructura bastante sólida para sujetar todo el conjunto. No tenemos componentes sueltos ni una distribución improvisada. La placa, los ventiladores y el disipador están colocados de forma que aprovechan la disposición de las rejillas exteriores que hemos visto en el apartado anterior.
También hay que tener presente que el adaptador de corriente se encuentra fuera del chasis. Esto libera bastante espacio interno y evita tener que refrigerar una fuente de alimentación adicional dentro del ordenador. Es una decisión que ayuda a reducir el tamaño del GR1X, aunque, como ya hemos comentado, nos obliga a tener el transformador externo sobre la mesa o escondido detrás del escritorio.
Después de desmontarlo, nos queda claro que ASUS ha dedicado buena parte de sus esfuerzos a la refrigeración. El GR1X no es simplemente un portátil sin pantalla metido dentro de una caja pequeña, sino un equipo con un sistema térmico diseñado para aprovechar las dimensiones y la distribución interna del chasis.
Ahora bien, tener dos ventiladores y un disipador de cobre de este tamaño no garantiza por sí solo unas buenas temperaturas. ASUS anuncia una capacidad térmica de 140 W, pero tendremos que comprobar qué ocurre cuando ponemos a trabajar simultáneamente la CPU y la GPU, cuánto tarda en estabilizarse la temperatura y, especialmente, a qué velocidad necesitan girar los ventiladores para mantenerla.
Este último punto nos interesa bastante. Los ventiladores de turbina permiten mover aire a través de disipadores muy compactos, pero también pueden resultar ruidosos cuando trabajan a muchas revoluciones. Por eso, más allá de las cifras de rendimiento, tendremos que comprobar cómo se comporta el GR1X durante un uso prolongado y si podemos trabajar con él sobre el escritorio sin que el ruido termine siendo molesto.
En cualquier caso, el interior nos ha parecido bastante interesante. ASUS ha aprovechado prácticamente cada centímetro del chasis y ha montado una refrigeración considerable para un ordenador que apenas supera el litro de volumen. Ahora toca comprobar si todo este trabajo se traduce en unas temperaturas y un rendimiento sostenido a la altura de lo que esperamos del NVIDIA RTX Spark N1X.
Pruebas de rendimiento del ASUS ProArt GR1X
Después de ver cómo es el ASUS ProArt GR1X por dentro y por fuera, llega el momento de comprobar de qué es capaz su NVIDIA RTX Spark N1X. Ya tuvimos ocasión de probar este procesador en el ProArt P16, pero ahora lo encontramos en un ordenador de sobremesa, con alimentación permanente y un sistema de refrigeración bastante diferente al del portátil.
Para estas pruebas hemos utilizado nuestra unidad del GR1X, equipada con el procesador N1X de 20 núcleos, su GPU Blackwell de 6.144 núcleos CUDA y 128 GB de memoria unificada. El equipo tiene instalado Windows 11 Pro para ARM y hemos pasado pruebas de CPU, GPU, memoria, almacenamiento e inteligencia artificial, además de una prueba de estabilidad prolongada con AIDA64.
Conviene recordar que estamos ante un ordenador ARM, por lo que no todas las aplicaciones de diagnóstico y benchmarking funcionan exactamente igual que en un sistema Intel o AMD. Por suerte, cada vez tenemos más herramientas compatibles, y en esta ocasión hemos podido completar una batería de pruebas bastante más amplia de lo que era posible con las primeras versiones de RTX Spark.
CPU-Z: identificando el NVIDIA RTX Spark N1X
Comenzamos con CPU-Z, utilizando su versión específica para Windows ARM64. Esta aplicación nos permite comprobar las características del procesador, las frecuencias de funcionamiento y obtener una primera referencia de su rendimiento.
El programa reconoce correctamente el NVIDIA RTX Spark N1X y sus 20 núcleos de CPU. También identifica la memoria LPDDR5X del sistema y la GPU Blackwell integrada. Sin embargo, algunos apartados todavía muestran información limitada o poco precisa, algo que ya vimos en su momento con el ProArt P16.


En cuanto al benchmark de CPU-Z, estos son los resultados que hemos obtenido:
| Prueba | ASUS ProArt GR1X |
|---|---|
| CPU Single Thread | 1149.0 |
| CPU Multi Thread | 16024.9 |
| Multi Thread Ratio | 13.9 |
La puntuación de un solo hilo nos permite conocer cómo responde el procesador cuando una aplicación utiliza únicamente un núcleo, algo importante en programas que no aprovechan bien el paralelismo. En multinúcleo, en cambio, el N1X puede repartir el trabajo entre sus 20 núcleos y alcanza los 16.024,9 puntos.
CPU-Z también nos permite comparar el resultado con otros procesadores ARM. En la captura hemos seleccionado como referencia un Qualcomm Snapdragon X Elite X1E001DE de 12 núcleos, que obtiene 820 puntos en un hilo y 9.165 puntos en multinúcleo dentro de la base comparativa del programa.
Con esta referencia, el N1X consigue aproximadamente un 40 % más de puntuación en un hilo y un 75 % más en multinúcleo. Eso sí, debemos recordar que estamos comparando puntuaciones del benchmark con una referencia interna de CPU-Z, no dos ordenadores que hayamos probado nosotros en las mismas condiciones.
Cinebench 2026: rendimiento de CPU en renderizado
La siguiente prueba es Cinebench 2026, la versión más reciente del benchmark de Maxon. Este programa utiliza cargas de renderizado para medir la potencia del procesador, tanto trabajando con un único hilo como utilizando todos los núcleos disponibles.

A diferencia de otras pruebas sintéticas más breves, Cinebench somete a la CPU a una carga considerable durante el proceso de renderizado, por lo que resulta útil para hacernos una idea de cómo responderá el equipo con aplicaciones que realizan cálculos intensivos.
| Prueba | Resultado |
|---|---|
| CPU Single Thread | 547 |
| CPU Multi Thread | 7245 |
| Relación multinúcleo | 13.23x |
Con 7.245 puntos en multinúcleo, el N1X demuestra que puede aprovechar sus veinte núcleos para acelerar el renderizado. La relación entre el resultado de un solo hilo y el multinúcleo es de 13,23 veces, una cifra que refleja el aumento de rendimiento al distribuir la carga entre los diferentes núcleos.
En este caso no hemos podido ejecutar la prueba específica de GPU de Cinebench, ya que el programa indica que no se cumplen sus requisitos para ese apartado. Esto no significa que la gráfica Blackwell sea incompatible con el renderizado por GPU en general, sino que esta prueba concreta no está disponible en nuestra configuración.
Por tanto, utilizaremos otros benchmarks para conocer el rendimiento gráfico del equipo.
Geekbench 7: rendimiento del procesador y de la GPU
Continuamos con Geekbench 7.1.0 Pro, que dispone de una versión para Windows ARM64 y nos permite evaluar tanto el procesador como la GPU mediante diferentes cargas de trabajo.
Geekbench utiliza pruebas relacionadas con compresión de archivos, procesamiento de imágenes, navegación, compilación y otras operaciones habituales. No mide únicamente la capacidad para realizar una operación matemática concreta, sino el comportamiento del procesador ante distintos tipos de tareas.

Los resultados de nuestra unidad han sido los siguientes:
| Prueba | Puntuación |
|---|---|
| CPU Single-Core | 2387 |
| CPU Multi-Core | 22788 |
| GPU OpenCL | 111718 |
En CPU conseguimos 2.387 puntos utilizando un único núcleo y 22.788 puntos cuando el benchmark aprovecha todos los núcleos disponibles. La diferencia vuelve a demostrar que el N1X está especialmente preparado para cargas de trabajo paralelas, aunque también ofrece un rendimiento por núcleo que resulta importante para el uso cotidiano de Windows.
La prueba gráfica es igualmente interesante. Geekbench identifica correctamente la GPU NVIDIA RTX Spark N1X con sus 6.144 núcleos CUDA y registra 111.718 puntos utilizando OpenCL.

Este benchmark mide operaciones de cálculo sobre la GPU, como procesamiento de imágenes, filtros, simulaciones y otros trabajos que pueden acelerarse mediante paralelismo. Por eso no debemos interpretar directamente su puntuación como una medida de los FPS que vamos a obtener en videojuegos.
Lo que sí confirma es que la parte gráfica del N1X puede asumir cargas de cálculo importantes, algo especialmente interesante para las aplicaciones profesionales y de inteligencia artificial a las que está orientado este ordenador.
Geekbench AI: pruebas de inteligencia artificial
También hemos aprovechado para ejecutar Geekbench AI 1.5.0, que mide el rendimiento del hardware al ejecutar diferentes operaciones relacionadas con redes neuronales e inferencia.

Este benchmark ofrece tres puntuaciones independientes según el formato numérico utilizado, ya que no todas las aplicaciones de inteligencia artificial trabajan con la misma precisión.
| Prueba | Puntuación |
|---|---|
| Single Precision | 1506 |
| Half Precision | 3076 |
| Quantized | 6102 |
Como podemos ver, la puntuación aumenta considerablemente cuando utilizamos formatos de menor precisión. Es algo que encaja con la filosofía de Blackwell, diseñada para acelerar determinados cálculos de inteligencia artificial mediante los núcleos Tensor.
La puntuación de precisión cuantizada supera en más de cuatro veces la obtenida con precisión simple, aunque no debemos entender esto como que todas las aplicaciones de IA vayan a funcionar cuatro veces más rápido. Cada modelo utiliza operaciones diferentes, y el resultado final depende tanto del hardware como de las bibliotecas y formatos compatibles.
Para conocer mejor el comportamiento del GR1X con modelos de lenguaje reales, más adelante analizaremos también los resultados obtenidos con MLPerf Client.
3DMark: rendimiento de la GPU Blackwell
Pasamos ahora a las pruebas gráficas con 3DMark, donde hemos utilizado Speed Way y Steel Nomad. Ambas nos permiten conocer el rendimiento de la GPU, aunque utilizan cargas de trabajo diferentes y sus puntuaciones no son directamente comparables.
Speed Way es una de las pruebas más interesantes para RTX Spark, ya que utiliza DirectX 12 Ultimate e incorpora tecnologías de renderizado modernas, incluyendo ray tracing. Steel Nomad, por su parte, somete a la gráfica a una carga elevada de rasterización, especialmente útil para conocer su capacidad de procesamiento gráfico.

Los resultados obtenidos han sido los siguientes:
| Benchmark | Puntuación | FPS |
|---|---|---|
| 3DMark Speed Way | 3167 | 31.68 |
| 3DMark Steel Nomad | 3611 | 36.12 |
En Speed Way hemos conseguido 3.167 puntos, con una tasa de 31,68 FPS. Es un resultado interesante porque se acerca bastante a las cifras de referencia que NVIDIA proporciona para los equipos RTX Spark de sobremesa.
De hecho, en su documentación oficial NVIDIA declara 3.141 puntos para Speed Way, mientras que nuestro GR1X consigue 3.167. Hablamos de una diferencia inferior al 1 %, por lo que podemos decir que nuestra unidad está funcionando prácticamente al nivel esperado para esta plataforma.
También podemos recuperar la referencia de nuestro análisis del ASUS ProArt P16, donde conseguimos 3.024 puntos en la misma prueba. El GR1X obtiene aproximadamente un 4,7 % más puntuación, una diferencia pequeña pero que apunta a un ligero aumento del rendimiento gráfico.
Eso sí, para atribuir esta diferencia al formato de sobremesa tendríamos que comprobar las frecuencias, los límites de potencia y las condiciones de funcionamiento de ambos equipos. No basta con tener una refrigeración más grande para garantizar automáticamente un rendimiento superior.
En Steel Nomad hemos obtenido 3.611 puntos, con 36,12 FPS. Aquí tenemos otra referencia del rendimiento gráfico del N1X, aunque sin una comparación directa con el portátil no podemos determinar cuánto ha mejorado respecto al ProArt P16.

Los resultados nos permiten situar mejor la GPU Blackwell integrada. Tenemos capacidad para ejecutar cargas gráficas exigentes y acceso a las tecnologías RTX, aunque no debemos esperar que su rendimiento sea equivalente al de una GeForce RTX 5070 dedicada simplemente porque ambas compartan el mismo número de núcleos CUDA.
CrystalDiskMark: rendimiento del SSD
Seguimos con el almacenamiento. Nuestra unidad monta un SSD NVMe de aproximadamente 1 TB, que hemos probado utilizando CrystalDiskMark 9.0.3 ARM64.

Este benchmark mide las velocidades de lectura y escritura de la unidad, tanto en transferencias secuenciales de archivos grandes como en operaciones aleatorias con bloques pequeños.
| Prueba | Lectura (MB/s) | Escritura (MB/s) |
|---|---|---|
| Secuencial Q8T1 | 7176.63 | 5942.61 |
| Secuencial Q1T1 | 1807.08 | 1720.96 |
| Aleatoria 4K Q32T1 | 174.00 | 305.76 |
| Aleatoria 4K Q1T1 | 33.45 | 56.95 |
Los resultados son buenos. Alcanzamos algo más de 7.100 MB/s en lectura secuencial y prácticamente 6.000 MB/s en escritura, unas velocidades que encajan con lo que esperamos de una unidad NVMe PCIe 4.0 rápida.
Esto significa que no deberíamos tener problemas para mover archivos de gran tamaño, instalar aplicaciones pesadas o trabajar con proyectos que requieran transferencias elevadas. También es una ventaja cuando utilizamos modelos de inteligencia artificial locales, ya que algunos pueden ocupar decenas de gigabytes y necesitamos cargarlos desde el almacenamiento antes de empezar a trabajar.
Las pruebas aleatorias, por su parte, nos permiten conocer mejor el comportamiento de la unidad al trabajar con numerosos archivos pequeños, algo más representativo de determinadas operaciones cotidianas del sistema operativo.
Aquí obtenemos 33,45 MB/s en lectura 4K Q1T1 y 56,95 MB/s en escritura, mientras que al aumentar la profundidad de cola alcanzamos 174 y 305,76 MB/s, respectivamente.
En definitiva, ASUS ha equipado nuestra unidad con un SSD que ofrece un rendimiento adecuado para las características del ordenador. No vemos un cuello de botella evidente en las pruebas secuenciales, aunque las velocidades por sí solas no permiten valorar aspectos como la resistencia de la unidad o su comportamiento durante escrituras muy prolongadas.
AIDA64: memoria unificada y caché
Otra de las pruebas que queríamos realizar era la de memoria, ya que es uno de los componentes más importantes de RTX Spark.
Como hemos explicado en el apartado de características, el N1X utiliza memoria LPDDR5X compartida entre CPU y GPU. En nuestro caso tenemos 128 GB instalados, una cantidad bastante elevada para un ordenador de estas dimensiones y especialmente interesante para trabajar con modelos de inteligencia artificial grandes.

Hemos utilizado AIDA64 Engineer 8.40 para medir las velocidades de lectura, escritura y copia, además de la latencia de acceso a memoria.
| Prueba | Resultado |
|---|---|
| Lectura de memoria | 131.43 GB/s |
| Escritura de memoria | 214.22 GB/s |
| Copia de memoria | 149.18 GB/s |
| Latencia de memoria | 16.8 ns |
| Lectura caché L1 | 2289.9 GB/s |
| Escritura caché L1 | 1752.6 GB/s |
| Copia caché L1 | 2739.5 GB/s |
| Latencia caché L1 | 1.4 ns |
| Lectura caché L2 | 1028.0 GB/s |
| Escritura caché L2 | 1583.7 GB/s |
| Copia caché L2 | 1220.6 GB/s |
| Latencia caché L2 | 3.5 ns |
Lo primero que llama la atención es la diferencia entre las velocidades de lectura y escritura de memoria. Mientras que la lectura alcanza 131,43 GB/s, la escritura llega hasta 214,22 GB/s. La velocidad de copia queda en 149,18 GB/s.
NVIDIA anuncia un ancho de banda máximo de 300 GB/s para la memoria del N1X, aunque no debemos comparar directamente esa cifra teórica con los resultados de AIDA64. El benchmark mide operaciones concretas desde la CPU, y en una arquitectura con memoria compartida el rendimiento también depende de cómo accede cada componente a ella.
Las cachés ofrecen velocidades considerablemente superiores, como era de esperar. La L1 supera los 2.200 GB/s en lectura y alcanza 2.739,5 GB/s en copia, con una latencia de solo 1,4 nanosegundos.
En el caso de la caché L2 obtenemos 1.028 GB/s en lectura y 1.583,7 GB/s en escritura, con una latencia de 3,5 ns.
Son resultados interesantes para conocer mejor el subsistema de memoria del procesador, aunque conviene recordar que AIDA64 todavía está adaptándose a las particularidades de los nuevos SoC ARM. De hecho, algunos campos relacionados con las cachés y la configuración de memoria no aparecen identificados correctamente.
En cualquier caso, la principal ventaja del GR1X no está únicamente en la velocidad de la memoria, sino en la posibilidad de poner una cantidad muy elevada a disposición de las aplicaciones aceleradas por GPU.
MLPerf Client: ejecutando modelos de inteligencia artificial
Para terminar los benchmarks hemos utilizado MLPerf Client, una herramienta diseñada para evaluar el rendimiento de sistemas que ejecutan modelos de inteligencia artificial.
A diferencia de Geekbench AI, que utiliza distintas operaciones sintéticas, MLPerf Client ejecuta modelos reales y mide aspectos como el tiempo necesario para generar el primer token y la velocidad a la que se produce el texto.
Hemos realizado pruebas con Llama 3.1 8B Instruct y Phi 4 Mini Instruct, utilizando WindowsML y llama.cpp como motores de ejecución.
El archivo de resultados nos proporciona estas cifras generales:
| Modelo | Motor | Primer token TTFT (s) | Generación (tokens/s) |
|---|---|---|---|
| Llama 3.1 8B Instruct | WindowsML | 0.30 | 57.2 |
| Llama 3.1 8B Instruct | llama.cpp | 0.25 | 54.1 |
| Phi 4 Mini Instruct | WindowsML | 0.15 | 102.3 |
| Phi 4 Mini Instruct | llama.cpp | 0.11 | 92.7 |
Los resultados reflejan unas velocidades bastante interesantes. Con Llama 3.1 8B superamos los 54 tokens por segundo en ambos motores, mientras que Phi 4 Mini alcanza más de 90 tokens por segundo.
Esto se traduce en una generación de texto suficientemente rápida para mantener una conversación fluida con estos modelos, sin tener que esperar demasiado entre la pregunta y la respuesta.
El tiempo hasta el primer token también es reducido. En Llama 3.1 8B se sitúa entre 0,25 y 0,30 segundos, mientras que Phi 4 Mini necesita entre 0,11 y 0,15 segundos.
Hay que tener presente que estas cifras corresponden a las condiciones concretas de MLPerf Client. Cuando utilizamos modelos con contextos muy largos, herramientas externas o varias conversaciones simultáneas, los tiempos pueden cambiar considerablemente.
También encontramos diferencias entre WindowsML y llama.cpp. En estas pruebas WindowsML obtiene una velocidad de generación ligeramente superior, mientras que llama.cpp consigue reducir algo el tiempo hasta el primer token.
Esto demuestra que el rendimiento no depende exclusivamente del hardware. La implementación del motor de inferencia y las optimizaciones disponibles para cada modelo también tienen un papel importante.
El informe incluye, además, resultados de diferentes tipos de tareas, como generación de contenido, escritura creativa, análisis de código y resúmenes de texto. En general, las velocidades más bajas aparecen cuando procesamos entradas más complejas, especialmente en los ejercicios de resumen y análisis de código.
Por ejemplo, con Llama 3.1 8B y llama.cpp pasamos de 56,9 tokens por segundo en generación de contenido a 51,2 tokens por segundo en una prueba de resumen de complejidad intermedia. No es una diferencia enorme, pero nos permite comprobar que la velocidad de generación puede variar dependiendo del trabajo realizado.
Una particularidad del informe es que MLPerf identifica 64 GB de RAM y 62 GB de memoria gráfica, mientras que Geekbench y CPU-Z reconocen 128 GB de memoria física. Por eso tomamos los resultados de inferencia como válidos para la configuración detectada por MLPerf, sin asumir que el benchmark haya utilizado toda la memoria instalada.
Ollama: probando modelos de IA de hasta 120B en local
Para terminar de comprobar las posibilidades del NVIDIA RTX Spark N1X en inteligencia artificial, hemos realizado una serie de pruebas adicionales utilizando Ollama 0.40.16. En esta ocasión hemos querido salir de los benchmarks convencionales y trabajar directamente con modelos de lenguaje, midiendo tanto la velocidad de generación como el tiempo necesario para procesar las instrucciones y su comportamiento cuando tenemos varias peticiones simultáneas.
Hemos elegido dos modelos bastante diferentes. Por un lado, Qwen3 8B, un modelo relativamente ligero que hemos ejecutado utilizando NVFP4. Por otro, Nemotron 3.5 Super 120B-A12B, un modelo mucho más grande que hemos cargado con cuantización Q4_K_M. Este último es especialmente interesante, porque necesita más de 91 GB de memoria y nos permite aprovechar una de las principales ventajas de los 128 GB de memoria unificada del GR1X.
La primera prueba consiste en generar texto con una ventana de contexto de 4.096 tokens. Con Qwen3 8B hemos obtenido 49,85 tokens por segundo, mientras que Nemotron 3.5 Super ha alcanzado los 40,77 tokens por segundo. Aunque el segundo modelo es muchísimo más grande, su arquitectura de mezcla de expertos permite que no todos sus parámetros participen en cada operación, lo que ayuda a mantener una velocidad de generación bastante razonable.
| Prueba | Qwen3 8B NVFP4 | Nemotron 3.5 Super 120B |
|---|---|---|
| Generación (tokens/s) | 49.85 | 40.77 |
| Tiempo hasta el primer token con carga (s) | 2.65 | 66.92 |
| Tiempo de carga (s) | 2.52 | 66.04 |
| Memoria GPU utilizada (GB) | 7.90 | 91.14 |
Aquí vemos una diferencia importante. Mientras que Qwen tarda apenas 2,52 segundos en cargar, Nemotron necesita algo más de un minuto. Sin embargo, una vez cargado, puede generar texto a más de 40 tokens por segundo.
Esto significa que el modelo grande requiere bastante más tiempo para empezar a trabajar, pero después ofrece una velocidad de respuesta perfectamente aprovechable. Además, debemos distinguir el tiempo del primer token con el modelo recién cargado del obtenido cuando ya está residente en memoria, porque son situaciones diferentes.
También hemos medido la velocidad de procesamiento de las instrucciones, conocida como prefill. Para ello hemos utilizado entradas de 512 y 4.096 tokens, manteniendo una ventana de contexto de 8.192 tokens.
| Modelo | Entrada de 512 tokens (tokens/s) | Entrada de 4096 tokens (tokens/s) |
|---|---|---|
| Qwen3 8B NVFP4 | 5694.96 | 6395.86 |
| Nemotron 3.5 Super 120B | 674.35 | 975.60 |
La diferencia es considerable. Qwen procesa las instrucciones mucho más rápido, mientras que Nemotron necesita más tiempo debido a su tamaño y complejidad. Con una entrada de 4.096 tokens, Qwen tarda 0,64 segundos en completar el prefill, frente a los 4,20 segundos de Nemotron.
Por último, hemos querido comprobar qué sucede cuando utilizamos el ordenador para atender varias peticiones al mismo tiempo. Para ello hemos comparado una única conversación con cuatro peticiones concurrentes.
| Modelo | Peticiones | Rendimiento total (tokens/s) | Rendimiento por petición (tokens/s) |
|---|---|---|---|
| Qwen3 8B NVFP4 | 1 | 47.81 | 48.68 |
| Qwen3 8B NVFP4 | 4 | 165.81 | 42.66 |
| Nemotron 3.5 Super 120B | 1 | 34.79 | 38.22 |
| Nemotron 3.5 Super 120B | 4 | 68.98 | 18.75 |
Con Qwen3, cuatro peticiones permiten alcanzar un rendimiento agregado de 165,81 tokens por segundo, manteniendo una velocidad por petición superior a los 42 tokens por segundo. En Nemotron también aumenta el rendimiento total, aunque la velocidad individual cae hasta los 18,75 tokens por segundo.
Esto es especialmente interesante si queremos utilizar el GR1X como servidor de inteligencia artificial local, por ejemplo, para dar servicio a varias aplicaciones, automatizaciones o agentes que estén trabajando simultáneamente. El equipo puede repartir su capacidad de cálculo entre distintas peticiones, aunque cuanto más exigente sea el modelo, mayor será la penalización que sufrirá cada una.
Después de estas pruebas, creemos que queda bastante claro dónde está una de las mayores ventajas del NVIDIA RTX Spark N1X. Poder cargar un modelo de 120B que ocupa más de 91 GB de memoria y generar texto a más de 40 tokens por segundo es un resultado muy interesante para un ordenador de estas dimensiones. No estamos hablando simplemente de ejecutar un pequeño chatbot local, sino de trabajar con modelos considerablemente más grandes sin tener que recurrir a varias tarjetas gráficas dedicadas.
Eso sí, los tiempos de carga y la pérdida de velocidad con varias peticiones simultáneas también dejan claro que disponer de mucha memoria no elimina las limitaciones de procesamiento. El GR1X puede ejecutar estos modelos, pero eso no significa que todos vayan a funcionar con la misma soltura. La arquitectura del modelo, la cuantización utilizada y la cantidad de usuarios concurrentes siguen siendo determinantes.
Temperaturas y estabilidad: más de una hora con AIDA64
Finalmente, hemos utilizado la prueba de estabilidad de AIDA64 para comprobar cómo responde el equipo durante una carga prolongada.
En la captura tenemos una sesión de algo más de una hora y doce minutos, con las opciones de estrés de CPU, FPU, caché, memoria, discos y GPU activadas. Durante la prueba, AIDA64 registra una utilización media de CPU del 99,7 %, lo que confirma que el procesador ha estado trabajando prácticamente al máximo durante el periodo medido.


También podemos comprobar que la frecuencia de CPU se mantiene alrededor de los 3.000 MHz, con un mínimo registrado de 2.981 MHz y un máximo de 3.035 MHz.
| Parámetro | Resultado registrado |
|---|---|
| Duración de la prueba | 1 h 12 min 9 s |
| Utilización media de CPU | 99.7 % |
| Frecuencia media de CPU | 3000 MHz |
| Frecuencia mínima | 2981 MHz |
| Frecuencia máxima | 3035 MHz |
| Temperatura máxima del SSD | 47 °C |
| Temperatura media del SSD | 43.3 °C |
La estabilidad de frecuencia es uno de los aspectos más interesantes. En la información registrada por AIDA64 no vemos grandes oscilaciones, sino valores muy próximos a los 3 GHz durante el periodo monitorizado.
Eso sí, debemos tener cuidado al interpretar las temperaturas. El sensor que muestra AIDA64 corresponde a la unidad SSD, identificada como MTFDKBA2T0QGN, y no a la CPU o la GPU. Por tanto, los 47 °C máximos que aparecen en la captura son la temperatura del almacenamiento, no la del NVIDIA RTX Spark N1X.
Para conocer la temperatura real del SoC necesitaremos una herramienta de monitorización que reconozca correctamente sus sensores. NVIDIA recomienda utilizar FrameView en Windows sobre ARM, ya que algunas aplicaciones tradicionales todavía presentan limitaciones con esta plataforma.
Lo que sí podemos extraer de esta prueba es que el equipo ha mantenido una utilización elevada de CPU durante más de una hora, sin que en las capturas aparezca una caída importante de la frecuencia registrada.
Este resultado es interesante teniendo en cuenta las dimensiones del GR1X. ASUS ha instalado un sistema de refrigeración con dos ventiladores de turbina y un gran disipador de cobre, y las frecuencias registradas durante la prueba son compatibles con un funcionamiento sostenido bastante estable.
No obstante, para valorar por completo la refrigeración también necesitaríamos medir el consumo eléctrico, la temperatura de CPU y GPU y el ruido generado por los ventiladores. Sin esos datos no sería correcto afirmar que el procesador trabaja a una temperatura determinada o que el equipo resulta silencioso bajo carga.
Conclusión, ¿merece la pena?
Después de completar todas las pruebas, tenemos bastante claro qué podemos esperar del ASUS ProArt GR1X. El NVIDIA RTX Spark N1X ofrece un buen rendimiento multinúcleo, acompañado de una GPU Blackwell que se defiende muy bien tanto en aplicaciones gráficas como en tareas de cálculo e inteligencia artificial. Y todo ello en un ordenador que apenas ocupa espacio sobre el escritorio, algo que hace unos años habría sido difícil de imaginar con un hardware de estas características.
Los 3.167 puntos obtenidos en 3DMark Speed Way confirman que nuestra unidad rinde prácticamente al nivel de referencia anunciado por NVIDIA y ligeramente por encima del ASUS ProArt P16 que analizamos anteriormente. Las pruebas de CPU-Z, Cinebench y Geekbench también han dejado buenos resultados, especialmente cuando entran en juego los veinte núcleos del procesador. Además, durante más de una hora de estrés hemos registrado frecuencias muy estables, próximas a los 3 GHz, aunque nos habría gustado poder monitorizar con mayor precisión las temperaturas del SoC.

Donde realmente hemos podido comprobar las posibilidades de RTX Spark ha sido trabajando con inteligencia artificial en local. No solo hemos conseguido ejecutar modelos pequeños con muy buenas velocidades de generación, sino que hemos cargado Nemotron 3.5 Super de 120B, utilizando más de 91 GB de memoria y manteniendo una velocidad superior a los 40 tokens por segundo. Es una prueba que difícilmente podríamos reproducir en una tarjeta gráfica convencional con 16 o 24 GB de VRAM sin recurrir a descargar parte del modelo en la memoria del sistema. Y precisamente por eso los 128 GB de memoria unificada del GR1X tienen tanto sentido.
Sin embargo, donde más sentido le encontramos a este ordenador es en la inteligencia artificial. Sus 128 GB de memoria unificada permiten trabajar con modelos que superarían la memoria gráfica disponible en muchas tarjetas dedicadas. A esto debemos sumar las optimizaciones de Blackwell, el soporte de CUDA y los buenos resultados que hemos obtenido en MLPerf, superando los 90 tokens por segundo con Phi 4 Mini. Para quienes trabajen habitualmente con modelos de lenguaje, generación de imágenes o desarrollo de aplicaciones de IA, estas características pueden marcar una diferencia importante.
Eso sí, el ASUS ProArt GR1X no es un ordenador para todo el mundo, y el precio tiene bastante que ver. NVIDIA sitúa el punto de partida de los equipos compactos RTX Spark en 4.399 dólares, aunque tendremos que consultar el precio definitivo del modelo de ASUS en España. Es una inversión considerable y, si lo que buscamos es simplemente un ordenador para trabajar, editar fotografías o jugar, podemos encontrar alternativas x86 mucho más económicas. Aquí estamos pagando por una plataforma muy específica, por su capacidad de memoria y por poder aprovechar todo el ecosistema NVIDIA RTX en un formato extraordinariamente compacto.
También hay algunos inconvenientes que debemos tener presentes. La memoria está integrada y no podemos ampliarla, las posibilidades de actualización del hardware son bastante reducidas y ASUS ha prescindido por completo de los puertos USB-A. A ello debemos sumar las limitaciones que todavía tiene Windows sobre ARM, especialmente con algunas aplicaciones, herramientas de diagnóstico y determinados videojuegos. La compatibilidad ha mejorado mucho, como ya comprobamos con el ProArt P16, pero sigue siendo recomendable asegurarnos de que los programas que necesitamos funcionan correctamente antes de dar el salto.
Con todo, el GR1X nos ha dejado muy buenas impresiones. No pretende competir con un sobremesa gaming convencional ni ofrecer la mejor relación entre precio y potencia para cualquier usuario. Su atractivo está en reunir un procesador de 20 núcleos, gráficos Blackwell y 128 GB de memoria unificada en un equipo de apenas 1,15 litros, con un rendimiento que hemos podido comprobar en nuestras propias pruebas. Para desarrolladores, creadores de contenido y usuarios que quieran trabajar con inteligencia artificial en local, es una propuesta muy interesante.
Por todo ello, otorgamos al ASUS ProArt GR1X nuestro galardón de Oro, destacando especialmente su excelente rendimiento y las posibilidades que ofrece la plataforma NVIDIA RTX Spark en un formato tan compacto.


Preguntas frecuentes
¿Qué es la memoria unificada y por qué resulta tan importante para la inteligencia artificial?
¿Qué significa que un procesador como el NVIDIA RTX Spark N1X use arquitectura ARM en lugar de x86?
¿Qué es CUDA y qué papel tiene en el rendimiento de una GPU Blackwell como la del N1X?
¿Qué es DLSS y cómo mejora el rendimiento en videojuegos compatibles con RTX?
¿Por qué algunos sistemas antitrampas de videojuegos multijugador pueden dar problemas en equipos con Windows para ARM?