
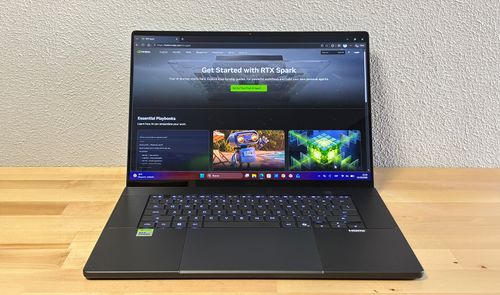
- Hemos viajado a San Francisco para conocer NVIDIA RTX Spark: así es la mayor revolución del PC en años
- Los portátiles con NVIDIA RTX Spark arrasan antes de llegar al mercado: ASUS ya se ha quedado sin stock
Llevamos muchos años viendo cómo los fabricantes intentan conseguir portátiles cada vez más potentes, ligeros y con mayor autonomía. Sin embargo, casi siempre se ha seguido la misma fórmula: un procesador Intel o AMD acompañado de una tarjeta gráfica dedicada, más o menos memoria RAM y una batería lo suficientemente grande como para aguantar varias horas lejos del enchufe. NVIDIA quiere cambiar esto por completo con RTX Spark, una nueva plataforma que combina una CPU ARM de 20 núcleos con una GPU Blackwell y memoria unificada. Y uno de los primeros equipos que podemos probar con esta tecnología es el ASUS ProArt P16 H7607.
En resumen
- El ASUS ProArt P16 H7607 integra el nuevo chip NVIDIA N1X, con CPU ARM de 20 núcleos y GPU Blackwell, dentro de la plataforma RTX Spark.
- El portátil incorpora 64 GB de memoria LPDDR5X unificada entre CPU y GPU, una pantalla OLED de 16 pulgadas y una batería de 99,9 Wh.
- En las pruebas, el NVIDIA N1X ejecuta modelos de lenguaje de hasta 32B parámetros, mueve Cyberpunk 2077 y ofrece unas 12 horas reproduciendo vídeo en 4K y hasta una hora y media en gaming con Ray Tracing.
El pasado 8 de octubre estuvimos en San Francisco, donde NVIDIA nos invitó a conocer RTX Spark y los primeros ordenadores que llegarán al mercado con esta tecnología. Durante el evento pudimos ver equipos de fabricantes como Dell, Microsoft, Lenovo y ASUS, además de numerosas demostraciones de inteligencia artificial, aplicaciones profesionales y videojuegos funcionando sobre esta nueva arquitectura.
La propuesta es bastante más ambiciosa de lo que puede parecer inicialmente. NVIDIA no ha diseñado simplemente un procesador para competir con Intel, AMD o Qualcomm, sino que ha aprovechado su experiencia en tarjetas gráficas y aceleración de inteligencia artificial para crear un chip que reúne prácticamente todos los componentes principales de un ordenador.
El resultado es una plataforma que utiliza una CPU Grace basada en ARM, una GPU con arquitectura Blackwell y una memoria compartida a la que pueden acceder ambos componentes. Todo ello manteniendo tecnologías que conocemos perfectamente de las tarjetas gráficas GeForce RTX, como CUDA, DLSS, los Tensor Cores y el trazado de rayos.
Esta última parte es especialmente interesante. Hasta ahora, si queríamos trabajar con modelos de inteligencia artificial de gran tamaño en un portátil, estábamos bastante limitados por la memoria de la tarjeta gráfica. Incluso teniendo 64 GB de RAM, una GPU con 8 o 12 GB de VRAM seguía siendo un problema para ejecutar determinados modelos de forma eficiente.
Con RTX Spark, NVIDIA quiere acabar con esa separación. La memoria unificada permite que la CPU y la GPU compartan un mismo espacio, de manera que podemos aprovechar mucha más capacidad para trabajar con modelos de lenguaje, generar imágenes, editar vídeo o manejar escenas 3D complejas.
Por supuesto, también hay incógnitas. La arquitectura ARM todavía tiene algunas limitaciones de compatibilidad en Windows, especialmente con determinados juegos, aplicaciones antiguas y programas que necesitan controladores específicos. Microsoft ha trabajado en mejorar la emulación mediante Prism, pero tendremos que comprobar hasta qué punto podemos utilizar este equipo como sustituto de un portátil tradicional.
Y precisamente eso es lo que queremos averiguar con este análisis. El ASUS ProArt P16 H7607 llega con una configuración encabezada por el NVIDIA N1X, 64 GB de memoria LPDDR5X y una pantalla OLED de 16 pulgadas. Esto nos deja un equipo preparado para creación de contenido, desarrollo e inteligencia artificial, pero que también promete defenderse en videojuegos gracias a su GPU Blackwell.

Vamos a conocerlo en detalle.
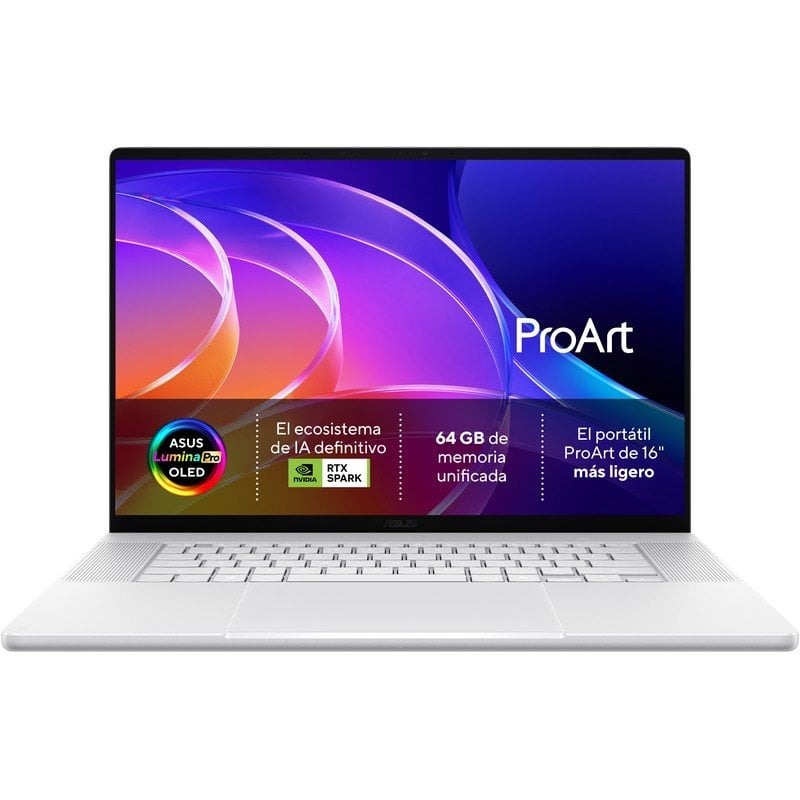

Características y especificaciones técnicas
El ASUS ProArt P16 H7607 pertenece a la familia de portátiles profesionales de ASUS, una gama que tradicionalmente ha estado orientada a diseñadores, fotógrafos, editores de vídeo y otros usuarios que necesitan un ordenador potente sin renunciar a la movilidad. La principal novedad de esta generación está en su interior. En lugar de recurrir a una combinación convencional de procesador y gráfica dedicada, ASUS ha apostado por NVIDIA RTX Spark, una plataforma que integra CPU, GPU, controladores de memoria y otros componentes dentro de un mismo SoC.
Estas son las características técnicas de la configuración que tenemos para analizar.
| Característica | Detalle |
|---|---|
| Modelo | ASUS ProArt P16 H7607 |
| Procesador | NVIDIA N1X (Grace ARM, 20 núcleos) |
| Arquitectura | NVIDIA RTX Spark |
| Tarjeta gráfica | NVIDIA Blackwell integrada |
| Núcleos CUDA | 6.144 |
| Tensor Cores | 5ª generación |
| RT Cores | 4ª generación |
| Memoria RAM | 64 GB LPDDR5X unificada |
| Ampliación de RAM | No, memoria soldada |
| Almacenamiento | SSD de 1 TB PCIe 4.0 |
| Pantalla | 16 pulgadas ASUS Lumina Pro OLED |
| Resolución | 2.8K (también llamado "3K") |
| Frecuencia de actualización | 120 Hz |
| Conectividad inalámbrica | Wi-Fi 7 |
| Puertos USB | 1 × USB 3.2 tipo A y 3 × USB4 tipo C |
| Batería | 99,9 Wh, 4 celdas |
| Carga | USB Power Delivery de 45 a 140 W |
| Sistema operativo | Windows 11 Pro ARM |
NVIDIA N1X: una CPU ARM y una GPU Blackwell en el mismo chip
El componente más importante de este portátil es, sin duda, su procesador NVIDIA N1X. Aunque estamos acostumbrados a hablar de NVIDIA como fabricante de tarjetas gráficas, en esta ocasión la compañía ha desarrollado una plataforma completa para ordenadores Windows, utilizando una arquitectura que hasta ahora asociábamos principalmente a sus soluciones profesionales y centros de datos.
La CPU utiliza tecnología Grace y cuenta con 20 núcleos ARM, distribuidos en dos clústeres. NVIDIA ha desarrollado esta parte del chip en colaboración con MediaTek, integrando también 16 MB de caché L3 y una NPU dedicada a determinadas tareas de inteligencia artificial.
Pero lo que realmente diferencia al N1X de otros procesadores ARM para Windows es su apartado gráfico. En su configuración de mayor rendimiento, el chip incorpora 6.144 núcleos CUDA basados en Blackwell, la misma arquitectura que NVIDIA utiliza en sus tarjetas gráficas GeForce RTX de última generación.
También dispone de Tensor Cores de quinta generación para acelerar operaciones de inteligencia artificial y RT Cores de cuarta generación para trabajar con trazado de rayos. Según NVIDIA, estos últimos duplican la tasa de intersección entre rayos y triángulos respecto a la generación anterior.
Esto significa que, aunque no tenemos una tarjeta gráfica dedicada como tal, sí disponemos de buena parte de las tecnologías que encontramos en una GeForce RTX convencional.
El chip es compatible con CUDA, TensorRT, DLSS, NVIDIA Reflex y las tecnologías de ray tracing de la compañía. Por tanto, no estamos ante una gráfica integrada convencional, aunque eso tampoco significa que vaya a ofrecer necesariamente el mismo rendimiento que una RTX dedicada de gama alta. La diferencia tendremos que buscarla en las pruebas, especialmente al ejecutar juegos exigentes, utilizar trazado de rayos y trabajar con aplicaciones profesionales que aprovechen la aceleración por GPU.
Otro componente importante es el motor de vídeo Blackwell, que incorpora aceleración por hardware para codificación y decodificación de vídeo 4:2:2, soporte para AV1 UHQ y mejoras en la decodificación H.264. Para un portátil orientado a creadores de contenido, estas capacidades pueden resultar especialmente útiles al editar grabaciones de cámaras profesionales, trabajar con archivos de alta resolución o exportar proyectos de vídeo.
64 GB de memoria unificada: una de sus grandes ventajas
Si hay una característica que merece especial atención en este ASUS ProArt P16, es su memoria. Nuestra unidad cuenta con 64 GB de LPDDR5X, una cantidad bastante generosa para un portátil, pero lo verdaderamente llamativo no es su capacidad, sino cómo está organizada.
En un ordenador convencional con gráfica dedicada tenemos dos espacios de memoria diferentes. Por un lado está la RAM del sistema, que utiliza principalmente el procesador, y por otro la VRAM de la tarjeta gráfica. Esto supone una limitación importante cuando trabajamos con aplicaciones que necesitan grandes cantidades de memoria gráfica. Podemos tener 64 GB de RAM instalados, pero si nuestra tarjeta gráfica dispone únicamente de 8 GB de VRAM, determinados modelos de inteligencia artificial no podrán ejecutarse íntegramente en la GPU.
RTX Spark utiliza un planteamiento diferente. La CPU Grace y la GPU Blackwell comparten memoria, eliminando la necesidad de mantener dos espacios físicos separados para sus datos. Además, NVIDIA utiliza una interconexión NVLink Chip-to-Chip con un ancho de banda bidireccional coherente de 600 GB/s para comunicar los bloques principales del SoC.
La plataforma admite configuraciones de hasta 128 GB de memoria LPDDR5X, con velocidades de hasta 9.400 MT/s y un ancho de banda máximo anunciado de 300 GB/s. Nuestro ASUS se queda en 64 GB, pero sigue siendo una capacidad muy interesante para trabajar con modelos de lenguaje que superan ampliamente la memoria disponible en las tarjetas gráficas de muchos portátiles.
Eso sí, hay que tener en cuenta que la memoria es compartida. Windows, las aplicaciones, la CPU y la GPU utilizan el mismo conjunto de memoria, por lo que no tendremos los 64 GB íntegramente disponibles para cargar modelos de inteligencia artificial.
También debemos recordar que la memoria está soldada, de manera que no podremos ampliarla posteriormente.
Una pantalla OLED pensada para trabajar con imagen y vídeo
ASUS lleva varias generaciones prestando especial atención a las pantallas de sus portátiles ProArt, y este modelo mantiene esa orientación profesional. El ProArt P16 H7607 incorpora un panel ASUS Lumina Pro OLED de 16 pulgadas, con una resolución de WQ+ (2880 x 1800). Durante la presentación de RTX Spark, ASUS también destacó las capacidades de esta familia de pantallas, incluyendo una frecuencia de actualización de hasta 120 Hz con VRR, un brillo máximo anunciado de hasta 1.600 nits y una precisión de color Delta E inferior a 1. Estas son características especialmente importantes para fotografía, edición de vídeo y diseño, donde la fidelidad de los colores resulta mucho más importante que en un portátil destinado únicamente a tareas de ofimática.
La tecnología OLED también tiene sus ventajas a la hora de trabajar con contenido HDR, gracias a la capacidad de apagar individualmente los píxeles y conseguir negros prácticamente absolutos. Por otra parte, la frecuencia de 120 Hz permite disfrutar de una mayor fluidez al movernos por Windows, trabajar con aplicaciones compatibles y, por supuesto, jugar. ASUS también ha incorporado un tratamiento antirreflejos, algo que agradecemos especialmente en equipos que vamos a utilizar fuera de casa o en entornos donde no siempre podemos controlar la iluminación.
Almacenamiento, conectividad y batería
El resto de las especificaciones acompañan bastante bien al planteamiento del equipo. En almacenamiento tenemos un SSD de 1 TB con interfaz PCIe 4.0, una capacidad razonable para instalar Windows, aplicaciones profesionales, juegos y mantener varios proyectos de trabajo. Sin embargo, cuando empezamos a utilizar modelos de inteligencia artificial locales, el espacio puede desaparecer bastante rápido. Algunos modelos ocupan varias decenas de gigabytes, por lo que tendremos que tenerlo en cuenta si pensamos utilizar el portátil principalmente para este tipo de tareas.
En cuanto a las conexiones, ASUS incluye un puerto USB 3.2 tipo A y tres puertos USB4 tipo C. Estos últimos permiten aprovechar conexiones de alta velocidad, algo especialmente útil para unidades SSD externas y otros periféricos profesionales. La conectividad inalámbrica corre a cargo de Wi-Fi 7, que también forma parte de las capacidades de la nueva plataforma de NVIDIA.
Otro apartado digno de mención es la batería. El ProArt P16 H7607 incorpora una unidad de cuatro celdas con 99,9 Wh de capacidad, una cifra muy próxima al límite habitual de 100 Wh establecido para transportar baterías de ion-litio en el equipaje de mano de los aviones.
NVIDIA ha insistido durante la presentación de RTX Spark en que sus nuevos equipos pueden mantener un rendimiento muy parecido tanto conectados a la corriente como funcionando con batería. Es una promesa importante, especialmente si tenemos en cuenta que muchos portátiles con gráficas dedicadas reducen considerablemente su rendimiento cuando desconectamos el cargador.
En cuanto a la alimentación, la información de configuración indica compatibilidad con USB Power Delivery entre 45 y 140 W, recomendando utilizar una fuente de 140 W o superior.
Windows 11 Pro ARM y el reto de la compatibilidad
Terminamos este repaso por las especificaciones con otro de los aspectos más importantes del equipo: el sistema operativo. Nuestro ASUS ProArt P16 H7607 viene con Windows 11 Pro ARM, una versión de Windows preparada para funcionar sobre procesadores con esta arquitectura. A simple vista, la experiencia es la misma que encontramos en cualquier otro ordenador con Windows 11. Tenemos nuestro escritorio, el explorador de archivos, las aplicaciones habituales y acceso al ecosistema de software de Microsoft. La diferencia está en cómo se ejecutan los programas.
Las aplicaciones desarrolladas específicamente para ARM pueden aprovechar directamente la arquitectura del procesador, mientras que muchas de las aplicaciones tradicionales de Windows necesitan utilizar Prism, la tecnología de emulación de Microsoft. NVIDIA y Microsoft han trabajado conjuntamente para mejorar esta compatibilidad, incluyendo soporte para instrucciones AVX y AVX2, optimizaciones específicas para RTX Spark y mejoras destinadas a ejecutar videojuegos y aplicaciones gráficas exigentes.
También se han realizado avances relacionados con los sistemas antitrampas utilizados en juegos multijugador, aunque eso no significa que todos los títulos sean compatibles desde el primer día. Este es uno de los apartados que más tendremos que vigilar durante el análisis. El rendimiento de un ordenador no sirve de mucho si después no podemos ejecutar las aplicaciones que necesitamos para trabajar.
Por suerte, NVIDIA también ha preparado un ecosistema de herramientas de inteligencia artificial para esta plataforma, con soporte para tecnologías como CUDA, TensorRT, Windows ML y diferentes aplicaciones destinadas a ejecutar modelos de lenguaje de forma local.
La compañía también ha anunciado compatibilidad con herramientas de desarrollo y generación de contenido como Ollama, LM Studio, llama.cpp y ComfyUI, entre otras. Todo esto convierte al ProArt P16 en un equipo especialmente interesante para quienes trabajan con inteligencia artificial, programación y creación de contenido. Ahora bien, todavía tenemos que comprobar cómo se traduce todo esto en el uso diario. Porque una cosa son las especificaciones y las demostraciones preparadas por NVIDIA, y otra muy distinta es instalar nuestros programas habituales, ejecutar nuestros juegos y utilizar el portátil durante varias horas seguidas.
Análisis externo
El ASUS ProArt P16 llega en una caja negra de líneas sencillas, con el logotipo ProArt en el centro de la tapa y la marca ASUS en uno de los laterales. La presentación encaja con el enfoque del equipo: discreta, sin fotografías del portátil ni una larga lista de características ocupando toda la superficie. Dependiendo del modelo, podemos encontrar también una caja más grande, dentro de la cual tendremos la que os enseñamos a continuación, junto con su transformador, una funda, y algunos accesorios como, por ejemplo, un ratón.

Una vez fuera de la caja, encontramos un diseño que mantiene esa misma idea. El acabado oscuro se extiende por la tapa, los laterales y la zona del teclado, con unas esquinas ligeramente redondeadas. El logotipo ProArt es el principal elemento decorativo de la cubierta y cambia de contraste según incide la luz.

Nuestra unidad lleva una pegatina de presentación bastante grande sobre la tapa, donde ASUS destaca la plataforma RTX Spark, la pantalla OLED y sus funciones de inteligencia artificial. Es un adhesivo pensado para retirarse antes de utilizar el equipo, como indica la propia etiqueta. Conviene también distinguir esas referencias comerciales de nuestra configuración: que se anuncien hasta 128 GB de memoria no significa que esta unidad los incorpore; la que hemos probado dispone de 64 GB.
Con 354,1 mm de ancho, 243 mm de fondo y un grosor de entre 12,9 y 15,9 mm, el ProArt P16 tiene un perfil bastante fino para tratarse de un portátil de 16 pulgadas. Su peso declarado es de 1,77 kg. Sigue siendo un equipo que necesita espacio en la mochila y sobre la mesa, pero sus dimensiones permiten plantearse llevarlo habitualmente de un sitio a otro.

Conectividad
Al mirar los laterales, nos encontramos con una selección de conexiones bastante práctica para un equipo destinado a trabajar con contenido. ASUS reparte los puertos entre ambos lados y conserva tanto USB-A como HDMI y un lector de tarjetas de tamaño completo.
En el lateral izquierdo tenemos la salida HDMI, dos conectores USB-C identificados con una velocidad de 40 Gbps y la toma combinada de 3,5 mm para auriculares y micrófono. Según las especificaciones del modelo, los USB-C son USB4 y admiten salida de imagen y alimentación. La presencia de dos de estos conectores en el mismo lado permite conectar varios dispositivos sin concentrarlo todo en un único puerto. Aun así, los tres USB-C del equipo están bastante próximos a la zona posterior de los laterales, un detalle que ayuda a dejar más despejado el espacio situado junto al reposamanos.

En el lateral derecho encontramos el lector SD, un USB-A marcado como 10 Gbps y un tercer USB-C de 40 Gbps. El USB-A nos viene bien para seguir utilizando periféricos y unidades externas sin adaptador, mientras que el lector permite introducir directamente una tarjeta de cámara.

ASUS deja claro que su modelo cubre todas las necesidades básicas en cuanto a conexión: tenemos conexiones para una pantalla externa, almacenamiento, tarjetas y periféricos sin recurrir necesariamente a una base. Eso sí, no encontramos un puerto Ethernet, de modo que, si necesitamos una conexión de red por cable, tendremos que utilizar un adaptador.
Base y ventilación
Al darle la vuelta al portátil, lo primero que llama la atención es la amplia superficie perforada de la base. Ocupa buena parte de la mitad posterior y se acompaña de varias filas de aberturas alargadas. Es una zona que conviene mantener despejada durante el uso, especialmente cuando ejecutamos juegos, renders o cargas de inteligencia artificial.

También vemos dos apoyos de goma largos, uno próximo al borde posterior y otro al delantero. Además de servir de apoyo, dejan una pequeña separación entre la cubierta inferior y la superficie de la mesa. La cubierta inferior está fijada mediante varios tornillos visibles. La memoria RAM está soldada, pero ASUS especifica dos ranuras M.2 2280 para almacenamiento, incluyendo las ocupadas.

Teclado y touchpad
Al abrirlo, nos encontramos con un teclado centrado, flanqueado por dos grandes zonas perforadas. ASUS prescinde del bloque numérico, por lo que el espacio disponible se reparte entre el teclado y esas rejillas laterales. Nuestra unidad de pruebas monta una distribución estadounidense, con tecla Intro horizontal y sin Ñ dedicada. Es un detalle que debemos tener presente al mirar las fotografías y que conviene comprobar al elegir la configuración comercial que vayamos a comprar.

Las teclas son de tipo isla, con las leyendas principales en blanco y una fila superior que combina las funciones F1–F12 con accesos de volumen, brillo, pantalla y otras opciones del equipo. Las flechas quedan agrupadas en la esquina inferior derecha; las de arriba y abajo tienen menor altura que las laterales. El botón de encendido está separado del teclado, sobre su esquina superior derecha. Nos parece una ubicación acertada para distinguirlo de las teclas que utilizamos al escribir.

El teclado incorpora retroiluminación, visible tanto en las leyendas como alrededor de las teclas. En las fotografías adquiere un tono azulado; más allá de ese aspecto, su utilidad está en facilitar la identificación de las teclas cuando trabajamos con poca luz.

Debajo tenemos un touchpad de gran tamaño, centrado respecto a la zona de escritura y que aprovecha buena parte del fondo del reposamanos. Su superficie es continua, sin botones independientes, y llega muy cerca del borde delantero. ASUS especifica un mecanismo háptico para este modelo.
Pantalla
La pantalla domina el conjunto una vez abierto. Los marcos laterales y el superior son estrechos, mientras que el inferior tiene algo más de altura e incorpora el logotipo ASUS. La cámara queda centrada en el borde superior. El formato 16:10 proporciona más espacio vertical que un panel panorámico 16:9, algo que aprovechamos al trabajar con documentos, código o interfaces con varias barras de herramientas. El modelo cuenta con opciones OLED de 16 pulgadas y 120 Hz, aunque debemos distinguir la variante concreta instalada de las características máximas anunciadas en la pegatina.

El ProArt P16 mantiene un diseño sobrio y una distribución bastante práctica. Sus elementos más destacados son el perfil fino, el touchpad amplio y una conectividad que conserva puertos útiles para trabajar con fotografía, vídeo y almacenamiento externo. La plataforma NVIDIA cambia lo que encontramos dentro, pero por fuera seguimos teniendo un portátil que podemos llevar a una reunión o colocar en una mesa de trabajo sin que su aspecto desentone.
Pruebas de rendimiento
Llegamos a una de las partes más esperadas de este ASUS ProArt P16: comprobar de qué es capaz el NVIDIA N1X cuando empezamos a exigirle. Estamos hablando de un procesador ARM de 20 núcleos acompañado de una GPU Blackwell y 64 GB de memoria unificada, una combinación bastante diferente a la que encontramos habitualmente en un portátil con Windows.
Para ponerlo a prueba hemos utilizado nuestros benchmarks habituales de procesador, gráfica y almacenamiento, pero también hemos querido dedicar bastante tiempo a la inteligencia artificial. Al fin y al cabo, es uno de los grandes argumentos de esta plataforma, y nos interesaba comprobar cómo se comporta ejecutando modelos de lenguaje y generando imágenes en local. También hemos realizado pruebas con aplicaciones de creación de contenido, como Blender y Photoshop. De esta forma podemos hacernos una idea más completa de su rendimiento, tanto en tareas convencionales como en aquellas que aprovechan especialmente la GPU.
Salvo que indiquemos lo contrario, todas las pruebas se han realizado con el portátil conectado a la corriente y la batería cargada al 100 %.
CPU-Z, GPU-Z y AIDA64
En una plataforma como esta, comprobar qué versión de cada herramienta estamos utilizando resulta especialmente importante. Windows en ARM puede ejecutar aplicaciones x86 y x64 mediante emulación, pero para identificar el hardware y medir su rendimiento conviene recurrir a versiones nativas siempre que estén disponibles.
Para esta tarea hemos utilizado CPU-Z 1.06 ARM64, la edición nativa para Windows en ARM. CPUID señala expresamente mejoras de compatibilidad con NVIDIA RTX Spark en esta versión. Por tanto, los resultados que presentamos a continuación corresponden a la versión nativa para ARM64.
La aplicación reconoce el N1X con diez núcleos de rendimiento Cortex-X925 y diez núcleos de eficiencia Cortex-A725, sumando veinte núcleos y veinte hilos. También identifica 64 GB de memoria y una tasa de transferencia de 9400 MT/s. La placa es una ASUS H7607BA, con BIOS Insyde H7607BA.303.


La pestaña gráfica reconoce los 6144 núcleos de la GPU y muestra 30,49 GB en su contador de memoria. Este dato no contradice por sí solo los 64 GB identificados en el equipo: en esta arquitectura unificada, las herramientas pueden consultar segmentos y presupuestos distintos. NVIDIA ya detalló en su presentación precisamente de esa diferencia entre la memoria dedicada reservada y la memoria compartida accesible desde CUDA.

En su benchmark integrado, versión 17.01.64, obtenemos 1193,7 puntos en un hilo y 16.251,5 puntos en multihilo, utilizando los veinte núcleos. La relación entre ambos resultados es de 13,6 veces.

En GPU-Z no hemos podido conseguir un resultado válido. Aquí debemos distinguir la aplicación de sus componentes de acceso al hardware: Windows puede emular código x86 y x64 en modo usuario, pero los controladores de núcleo necesitan una versión ARM64. Esta misma limitación afecta a algunos sistemas antitrampas cuando dependen de un controlador sin adaptar. Y al intentar cargar este controlador, el PC obtuvo un pantallazo azul.
Por otro lado, AIDA64 también nos ha permitido consultar buena parte de la información del equipo. Hemos podido identificar el procesador, consultar los datos de la placa base ASUS H7607BA y ejecutar las pruebas de rendimiento de memoria.
| Prueba | Lectura (GB/s) | Escritura (GB/s) | Copia (GB/s) | Latencia (ns) |
|---|---|---|---|---|
| Memoria | 131,79 | 220,10 | 154,05 | 14,5 |
| Caché L1 | 2295,6 | 1754,5 | 2630,2 | 1,4 |
| Caché L2 | 1025,7 | 1579,2 | 1204,5 | 3,3 |
Los resultados son especialmente interesantes por las velocidades de transferencia y las latencias que hemos obtenido. La memoria unificada es uno de los elementos más importantes de esta arquitectura, ya que tanto la CPU como la GPU pueden acceder a ella sin necesidad de disponer de dos bloques de memoria independientes.
Eso sí, hay un detalle que debemos tener presente al interpretar las cifras. AIDA64 se está ejecutando como una aplicación x64 mediante Prism, la capa de emulación de Windows ARM. Esto significa que los resultados pueden verse afectados por la propia emulación y no tienen por qué reflejar exactamente el rendimiento que obtendríamos con una herramienta nativa.

Por ese motivo, preferimos tomarlos como una referencia del comportamiento de AIDA64 en este equipo, y no como una medición definitiva de las capacidades de la memoria. Lo mismo ocurre con algunos campos de caché que aparecen vacíos: no significa necesariamente que el procesador carezca de esos niveles, sino que el programa no ha conseguido identificarlos.
Cinebench 2026
Empezamos las pruebas de procesador con Cinebench 2026, uno de los benchmarks que más utilizamos para medir el rendimiento de la CPU. Su funcionamiento es bastante sencillo: pone al procesador a renderizar una escena tridimensional y mide cuánto trabajo consigue completar.
La prueba Single Thread utiliza un único hilo de ejecución, mientras que Multiple Threads intenta aprovechar todos los recursos disponibles. Esto nos permite comprobar tanto la potencia por hilo como la capacidad del procesador para repartir una tarea exigente entre sus distintos núcleos.
| Prueba | Resultado | Unidad |
|---|---|---|
| CPU Single Thread | 553 | Puntos |
| CPU Multiple Threads | 6999 | Puntos |
| Relación MP | 12,66 | Veces |
Single Thread ejecuta la carga con un único hilo. Single Core permite evaluar un núcleo aprovechando sus capacidades SMT, es decir, los hilos de hardware que puede ejecutar ese núcleo. Maxon identifica expresamente esta segunda modalidad como una prueba para núcleos compatibles con SMT. Nuestro N1X dispone de veinte núcleos y veinte hilos, sin SMT. Por ello, la prueba pertinente para medir su rendimiento individual es Single Thread.

En nuestro caso hemos obtenido 553 puntos en Single Thread y 6999 puntos en Multiple Threads. En el caso del N1X, hay un factor clave: no todos sus núcleos son iguales. Esta CPU cuenta con diez cores Cortex-X925 de alto rendimiento y otros diez Cortex-A725, orientados a la eficiencia, con una diferencia notable en cuanto a potencia. Así, la prueba Single Thread se ejecuta normalmente en uno de los núcleos rápidos, así que su resultado no se puede multiplicar por 20 para estimar el multinúcleo.
Teniendo esto en cuenta, un escalado de 12,66 veces es un muy buen resultado. Además, es coherente con las 13,6 veces que obtuvimos en el benchmark de CPU-Z, lo que indica que el procesador mantiene bien el rendimiento cuando se cargan todos sus núcleos durante una prueba más larga.
También hemos repetido el test tirando solo de batería. Y los resultados, como promete NVIDIA, son muy muy similares, con una pérdida de en torno al 10 – 12%, y una escalada, como vemos en el MP Ratio, prácticamente idéntica.

Es una auténtica bestia este procesador. Pero vamos a seguir haciendo comprobaciones.
Geekbench 7
Continuamos con Geekbench 7, una prueba bastante diferente a Cinebench. En lugar de centrarse exclusivamente en el renderizado, utiliza pequeñas cargas de trabajo que representan operaciones habituales en un ordenador: compresión de archivos, compilación de código, tratamiento de fotografías, procesamiento de texto y cálculos matemáticos, entre otras. Esto resulta especialmente útil en un equipo como el ProArt P16, que no está pensado únicamente para realizar una tarea concreta.
Para nuestras pruebas hemos utilizado Geekbench 7.1.0 Pro en su versión nativa para Windows AArch64, evitando así los posibles efectos de la emulación.
| Prueba | Puntuación |
|---|---|
| CPU Single-Core | 2636 |
| CPU Multi-Core | 22882 |
| GPU OpenCL | 119517 |
| GPU CUDA | 188245 |
Los resultados han sido de 2.636 puntos en mononúcleo y 22.882 puntos en multinúcleo. Si nos fijamos en las pruebas individuales, encontramos algunos resultados bastante peculiares. Por ejemplo, en Clang, que mide el rendimiento compilando código, pasamos de 14,8 Klines/s utilizando un núcleo a 165,2 Klines/s al aprovechar varios.
En Photo Library, una prueba relacionada con el tratamiento de imágenes, obtenemos 9,31 imágenes por segundo en mononúcleo y 92 imágenes por segundo en multinúcleo.
También merece la pena detenerse en Ray Tracer, que pasa de 623,1 Ksamples/s a 10,5 Msamples/s.
Lo que nos llama la atención de estos resultados es comprobar que no todas las aplicaciones aprovechan el procesador de la misma manera. Algunas consiguen repartir muy bien el trabajo, mientras que otras encuentran antes sus propios límites. Precisamente por eso nos gusta complementar Cinebench con Geekbench.
| Prueba | Mononúcleo | Multinúcleo | Unidad |
|---|---|---|---|
| Clang | 14,8 | 165,2 | Klines/s |
| Photo Library | 9,31 | 92,0 | Imágenes/s |
| Ray Tracer | 0,6231 | 10,5 | Msamples/s |
Además de las pruebas de CPU, hemos aprovechado para medir el rendimiento de la GPU utilizando dos interfaces diferentes: OpenCL y CUDA. Con OpenCL hemos conseguido 119.517 puntos, mientras que con CUDA la puntuación asciende hasta los 188.245 puntos.
| Prueba | OpenCL (Mpixels/s) | CUDA (Mpixels/s) |
|---|---|---|
| Path Tracer | 198,6 | 206,2 |
La diferencia es importante: CUDA obtiene una puntuación aproximadamente un 57,5 % superior.
Ahora bien, esto no significa que cualquier aplicación vaya a funcionar un 57,5 % más rápido simplemente por utilizar CUDA. Cada prueba tiene sus propias características y, de hecho, encontramos casos en los que las diferencias son mucho menores.
Un buen ejemplo es Path Tracer, donde registramos 198,6 Mpixels/s con OpenCL y 206,2 Mpixels/s con CUDA.
En cualquier caso, los resultados dejan claro que la elección de la API puede tener bastante importancia a la hora de aprovechar esta GPU Blackwell.
3DMark
Para comprobar el rendimiento gráfico hemos recurrido a 3DMark, utilizando dos pruebas que exigen bastante a cualquier GPU moderna: Steel Nomad y Speed Way.
Steel Nomad está diseñada para poner a trabajar a la gráfica con una escena tridimensional compleja, utilizando técnicas de renderizado convencionales y sin depender del trazado de rayos. Es una buena forma de comprobar su potencia gráfica en una carga sostenida.

Speed Way, por su parte, utiliza DirectX 12 Ultimate e incorpora ray tracing, por lo que nos permite comprobar cómo responde la arquitectura Blackwell cuando entran en juego estas técnicas de iluminación.

En ambas pruebas nos hemos movido alrededor de los 30 FPS, algo que resulta interesante teniendo en cuenta que estamos hablando de una GPU integrada dentro del propio procesador.
| Prueba | Puntuación | Rendimiento gráfico (FPS) |
|---|---|---|
| Steel Nomad 1.0 DX12 | 2980 | 29,81 |
| Speed Way 1.1 | 3024 | 30,24 |
Eso sí, no debemos interpretar estos resultados como si ambas pruebas fueran equivalentes. Steel Nomad y Speed Way utilizan escenas, resoluciones y técnicas diferentes. Por tanto, que las dos se sitúen cerca de los 30 FPS no significa que el ray tracing apenas tenga impacto en el rendimiento.
Recordamos que la GPU del N1X tiene 6.144 núcleos CUDA, los mismos que una RTX 5070 de sobremesa, pero con un consumo de GPU que en nuestras pruebas no pasó de unos 67 W, así como una memoria compartida a 300 GB/s. Eso explica por qué rinde bastante por debajo de esa tarjeta pese a tener los mismos núcleos.
CrystalDiskMark
Pasamos ahora al almacenamiento. Nuestro ASUS ProArt P16 incorpora un SSD Samsung MZVL81T0HFLB-00BTW de 1 TB, conectado mediante una interfaz PCIe 4.0 x4. Para comprobar su rendimiento hemos utilizado CrystalDiskMark 9.0.3 ARM64, configurado con tres pasadas y un tamaño de prueba de 1 GiB. Recordamos que, como el portátil tenía activado por defecto Bitlocker, la velocidad de escritura en colas bajas puede verse afectada.
| Prueba | Lectura (MB/s) | Escritura (MB/s) |
|---|---|---|
| SEQ1M Q8T1 | 7211,51 | 5784,05 |
| SEQ1M Q1T1 | 2560,87 | 819,69 |
| RND4K Q32T1 | 438,06 | 372,25 |
| RND4K Q1T1 | 46,70 | 69,74 |
CrystalDiskMark realiza varias pruebas diferentes. Las secuenciales miden la velocidad de lectura y escritura de archivos grandes, mientras que las aleatorias utilizan bloques mucho más pequeños, similares a los que encontramos cuando Windows o una aplicación acceden a numerosos archivos. También modifica la profundidad de cola, es decir, el número de operaciones que el SSD debe atender simultáneamente.

En nuestras pruebas hemos comprobado que la unidad alcanza sus mejores resultados secuenciales cuando tiene varias operaciones pendientes. Sin embargo, al reducir la profundidad de cola, la velocidad de escritura cae de manera bastante pronunciada. Esto no significa necesariamente que el SSD funcione mal. Simplemente nos recuerda que las velocidades máximas que anuncian los fabricantes suelen corresponder a unas condiciones muy concretas, y que el rendimiento cambia según el tipo de trabajo.
Ollama / llama.cpp
Llegamos a uno de los apartados que más ganas teníamos de probar: la ejecución de modelos de lenguaje en local. Una de las ventajas de este NVIDIA N1X es que dispone de 64 GB de memoria unificada, lo que permite trabajar con modelos relativamente grandes sin depender de una GPU dedicada con su propia VRAM.
Para comprobarlo hemos utilizado Ollama y llama.cpp, dos herramientas muy conocidas entre quienes ejecutan modelos de inteligencia artificial en sus propios equipos.
Aquí hay dos aspectos que nos interesa medir por separado. El primero es el prefill, que corresponde al procesamiento de la información que enviamos al modelo. El segundo es la generación de tokens, que determina la velocidad a la que recibimos la respuesta.
También hemos registrado el tiempo hasta recibir el primer token, aunque esta cifra requiere cierta precaución porque puede incluir la carga inicial del modelo en memoria.
Con Ollama hemos utilizado Qwen3 8B y Qwen3 32B en NVFP4, realizando tres repeticiones de cada configuración.
| Modelo | Ventana configurada (tokens) | Generación mediana (tokens/s) | Primer token mediano con recarga (s) |
|---|---|---|---|
| Qwen3 8B NVFP4 | 4096 | 48,8198 | 2,5243 |
| Qwen3 8B NVFP4 | 32768 | 48,5792 | 2,7929 |
| Qwen3 32B NVFP4 | 4096 | 13,8887 | 5,1631 |
| Qwen3 32B NVFP4 | 32768 | 13,9047 | 5,3226 |
Como cabía esperar, el modelo de 8.000 millones de parámetros genera texto bastante más rápido. Con el modelo de 32B nos situamos alrededor de los 14 tokens por segundo. Es una velocidad que permite mantener una conversación, aunque la respuesta se va construyendo de forma bastante más pausada que con el modelo pequeño.
En todas estas pruebas de generación hemos utilizado una entrada de 43 tokens y limitado la salida a 256 tokens. Esto es importante porque, aunque configuremos una ventana de contexto de 32K, no estamos introduciendo realmente 32.000 tokens de información. Por tanto, no podemos utilizar estos resultados para afirmar que el rendimiento apenas cambia cuando llenamos contextos grandes.
Además, los tiempos hasta el primer token incluyen la carga del modelo, por lo que tampoco representan necesariamente la espera que tendríamos durante una conversación en la que el modelo ya permanece cargado en memoria.
Para medir el prefill con entradas más largas, hemos realizado una segunda tanda con 512 y 4096 tokens efectivos, manteniendo una ventana de contexto de 8192 tokens. Utilizamos los mismos modelos NVFP4, temperatura cero, semilla 42 y modo raw, sin plantilla de conversación. Tras una ejecución de calentamiento, realizamos tres mediciones por combinación y comprobamos que no se reutilizaran tokens de entrada desde caché.
| Modelo | Tokens de entrada | Prefill mediano (tokens/s) | Tiempo mediano de procesamiento (s) |
|---|---|---|---|
| Qwen3 8B NVFP4 | 512 | 4145,72 | 0,123501 |
| Qwen3 8B NVFP4 | 4096 | 4358,97 | 0,939672 |
| Qwen3 32B NVFP4 | 512 | 1017,58 | 0,503153 |
| Qwen3 32B NVFP4 | 4096 | 1057,03 | 3,875000 |
Aquí vemos que el modelo de 8B procesa la entrada aproximadamente cuatro veces más rápido que el de 32B. Con 4096 tokens necesita algo menos de un segundo, mientras que el modelo grande emplea unos 3,88 segundos. Las tasas mejoran ligeramente al ampliar la entrada, aunque el tiempo total aumenta porque hay más información que procesar.
Estos tiempos corresponden exclusivamente al procesamiento de la entrada: no incluyen la carga del modelo ni la generación de una respuesta completa. Además, utilizamos texto sintético repetitivo para controlar el número de tokens, por lo que estamos midiendo velocidad de procesamiento, no comprensión de documentos o calidad de las respuestas.
Para profundizar un poco más, hemos utilizado llama-bench b11669 con CUDA, ejecutando Qwen3 8B NVFP4. En esta ocasión hemos configurado 20 hilos, una salida de 128 tokens y caché K/V en formato f16.
| Carga | Contexto de 4096 tokens (tokens/s) | Contexto de 32768 tokens (tokens/s) |
|---|---|---|
| Prefill mediano | 4427,1681 | 2655,8591 |
| Generación mediana | 44,4473 | 26,1271 |
El objetivo es comprobar cómo cambia la velocidad de generación cuando aumentamos la profundidad del contexto. En nuestras mediciones hemos registrado una caída aproximada del 41,2 % al pasar de 4096 a 32.768 tokens de profundidad, bajando de 44,45 a 26,13 tokens por segundo. Esto tiene bastante importancia en el uso real. No es lo mismo pedirle al modelo que responda una pregunta sencilla que mantener una conversación larga, analizar un documento extenso o trabajar con un asistente de programación que acumula mucho contexto.
ComfyUI (Flux2 Dev NVFP4)
La generación de imágenes es otra de las tareas donde queríamos comprobar el potencial de esta plataforma. Para ello hemos utilizado ComfyUI, una herramienta que permite ejecutar modelos de generación de imágenes mediante workflows configurables. En nuestro caso hemos trabajado con Flux2 Dev NVFP4 y Klein 4B NVFP4.
Empezamos con Flux2 Dev NVFP4, generando imágenes de 1024 × 1024 píxeles, con 20 pasos, sampler Euler, guidance 4 y un lote de una sola imagen. Tras realizar el calentamiento inicial, hemos obtenido cinco tiempos consecutivos de 41,47, 41,39, 41,47, 41,42 y 41,41 segundos.
La mediana se sitúa en 41,42 segundos por imagen, por debajo de los 44,8 segundos mostrados por NVIDIA en su presentación. No obstante, para interpretar esa diferencia como una ventaja directa tendríamos que confirmar que ambas pruebas utilizan exactamente el mismo workflow y las mismas condiciones.
| Medición | Tiempo cliente (s) |
|---|---|
| Repetición 1 | 41,465236 |
| Repetición 2 | 41,388574 |
| Repetición 3 | 41,4692717 |
| Repetición 4 | 41,4218597 |
| Repetición 5 | 41,4079033 |
| Mediana | 41,4218597 |
Lo que más nos ha gustado de esta tanda no ha sido únicamente el tiempo, sino su regularidad. Apenas encontramos diferencias entre las cinco generaciones, lo que indica que durante esa sesión el rendimiento se mantuvo bastante estable.
Sin embargo, al revisar las mediciones anteriores, encontramos algo que merece la pena comentar. En otra sesión habíamos registrado una mediana prácticamente idéntica, de 41,40 segundos, pero también tenemos una tanda en la que el tiempo ascendió hasta los 111,19 segundos.
| Sesión | Flux2 Dev NVFP4 mediana cliente (s) | Flux2 Klein 4B NVFP4 mediana cliente (s) |
|---|---|---|
| Sesión 1 | 111,1934852 | 14,5851218 |
| Sesión 2 | 41,3962339 | 48,5408415 |
| Sesión 3 | 41,4218597 | 15,1327882 |
Es una diferencia demasiado grande como para pasarla por alto. No tenemos datos suficientes para determinar si se debió a la gestión de memoria, al estado del sistema, a la configuración o a algún otro factor. Por eso presentamos los 41,42 segundos como el resultado de la última tanda disponible de Flux2 Dev, sin ocultar que anteriormente habíamos encontrado una variación importante.
También hemos probado Klein 4B NVFP4, manteniendo la resolución de 1024 × 1024 píxeles, los 20 pasos y el sampler Euler, aunque utilizando CFG 5. Inicialmente obtuvimos medianas de 14,59, 48,54 y 15,13 segundos en diferentes sesiones. Para comprobar si podíamos reproducir los tiempos más bajos, hemos realizado una nueva tanda con calentamiento y cinco generaciones adicionales:
| Repetición | Tiempo por imagen (s) |
|---|---|
| 1 | 14,2868587 |
| 2 | 14,5029089 |
| 3 | 14,5827613 |
| 4 | 15,1393856 |
| 5 | 15,1221930 |
| Mediana | 14,5827613 |
La nueva mediana de 14,58 segundos por imagen vuelve a situarnos cerca de las dos sesiones más rápidas. Además, hemos comprobado que el sampler se ejecuta en las cinco generaciones, sin reutilizar su resultado desde caché, aunque sí se mantienen nodos auxiliares.
En esta ocasión también contamos con monitorización durante la prueba. Con el equipo conectado a la corriente, registramos una temperatura máxima muestreada de GPU de 75 °C, una utilización de hasta el 96 % y una lectura máxima de potencia de 67,44 W. Esta última corresponde al contador de GPU disponible, no al consumo total del portátil.
Esta repetición refuerza que Klein puede completar el workflow alrededor de los quince segundos de forma consistente dentro de una sesión. Sin embargo, no explica por qué aquella tanda necesitó 48,54 segundos. Sin telemetría equivalente de la ejecución lenta, no podemos atribuirla a falta de memoria, reparto del modelo o limitaciones térmicas.
MLPerf Client 2.0
Continuamos con MLPerf Client 2, una herramienta que nos permite medir el rendimiento de diferentes modelos de inteligencia artificial utilizando distintos sistemas de ejecución. Aquí no solo nos interesa la velocidad de generación de texto, sino también cómo responde el equipo cuando el modelo debe realizar tareas más complejas.
En las pruebas de lenguaje hemos utilizado diferentes combinaciones de modelos y motores de inferencia.
| Modelo | Backend | TTFT global (s) | Generación global (tokens/s) |
|---|---|---|---|
| Llama 3.1 8B Instruct | WindowsML | 0,34 | 56,8 |
| Llama 3.1 8B Instruct | llama.cpp | 0,27 | 54,9 |
| Phi 4 Mini Instruct | WindowsML | 0,17 | 103,5 |
| Phi 4 Mini Instruct | llama.cpp | 0,13 | 86,3 |
| Phi 4 Reasoning 14B | WindowsML | 0,86 | 21,0 |
| Phi 4 Reasoning 14B | llama.cpp | 0,91 | 28,0 |
| Qwen 3 8B | llama.cpp | 0,26 | 53,9 |
Los resultados muestran algo bastante curioso: no existe un motor que sea siempre el más rápido. Con Phi 4 Mini, WindowsML consigue una mayor velocidad de generación, mientras que con Phi 4 Reasoning es llama.cpp el que obtiene mejores resultados. Esto demuestra que el rendimiento de la inteligencia artificial no depende únicamente del procesador o de la GPU. El modelo utilizado, su formato y el motor encargado de ejecutarlo también tienen bastante importancia.
Además de estas pruebas, hemos ejecutado los escenarios SWE Agent, orientados a medir tareas agénticas relacionadas con el desarrollo de software. En este tipo de cargas el modelo no se limita a generar una respuesta. También debe interactuar con herramientas, procesar sus resultados y continuar trabajando hasta completar la tarea.
Con Llama sobre WindowsML hemos registrado una duración esperada media de 58,855 segundos, mientras que utilizando llama.cpp el tiempo baja hasta los 45,928 segundos. Con Qwen sobre llama.cpp obtenemos 72,368 segundos.
| Modelo | Backend | Avg Expected Duration (s) | Avg Tools Duration (s) |
|---|---|---|---|
| Llama 3.1 8B Instruct | WindowsML | 58,855 | 9,670 |
| Llama 3.1 8B Instruct | llama.cpp | 45,928 | 6,587 |
| Qwen 3 8B | llama.cpp | 72,368 | 6,612 |
También hemos registrado los tiempos dedicados a herramientas: 9,670 segundos con Llama/WindowsML, 6,587 segundos con Llama/llama.cpp y 6,612 segundos con Qwen/llama.cpp. Estas cifras ayudan a entender que, en una tarea agéntica, el tiempo total no depende exclusivamente de la velocidad a la que el modelo genera tokens.
Por último, la única prueba de nuestra batería que no pudimos llevar a cabo fue la de QNN, el motor de IA de Qualcomm, ya que está diseñado para los Snapdragon, y no está pensado para correr en un chip de NVIDIA.
Blender
Dejamos a un lado la inteligencia artificial para volver a una aplicación profesional más convencional: Blender. Este programa nos permite comprobar cómo responde la GPU cuando tiene que renderizar escenas tridimensionales complejas, con materiales, iluminación y geometría exigentes.
Para nuestras pruebas hemos utilizado Blender 5.3.0 Beta con Cycles y aceleración OptiX, aprovechando las capacidades de la GPU NVIDIA. Hemos seleccionado dos escenas diferentes y realizado tres renders de cada una.
| Escena | Resolución | Muestras | Repetición 1 (s) | Repetición 2 (s) | Repetición 3 (s) | Mediana (s) |
|---|---|---|---|---|---|---|
| Barbershop | 2048 × 858 | 800 | 88,8172 | 88,0686 | 87,8433 | 88,0686 |
| HairStyleDLSS | 1920 × 1080 | 4096 | 312,6250 | 310,1740 | 296,2469 | 310,1740 |
En Barbershop hemos obtenido tiempos de 88,82, 88,07 y 87,84 segundos. Como podemos ver, las diferencias entre ejecuciones son pequeñas, algo que nos permite utilizar la mediana como una referencia bastante representativa del comportamiento del equipo en esta escena.
HairStyleDLSS es una carga mucho más larga. Aquí hemos registrado 312,63, 310,17 y 296,25 segundos. La mediana queda en 310,17 segundos, algo más de cinco minutos. En este caso sí encontramos una variación algo mayor entre las tres ejecuciones, aunque no tenemos información suficiente para atribuirla a un factor concreto.
Estas pruebas son especialmente interesantes porque permiten comprobar el rendimiento de la GPU fuera de los benchmarks sintéticos. Aquí estamos utilizando un motor de renderizado real, con escenas que exigen una cantidad considerable de trabajo gráfico.
PugetBench
Otra de las aplicaciones que no podía faltar en un ProArt es Photoshop nativo en ARM. Para medir su rendimiento hemos utilizado PugetBench, un benchmark que automatiza diferentes operaciones dentro del propio programa de Adobe.
En lugar de realizar una prueba sintética, PugetBench trabaja con tareas similares a las que podemos encontrar durante una sesión de edición fotográfica: apertura de archivos RAW, redimensionado de imágenes, aplicación de máscaras, filtros y guardado de documentos.
Hemos ejecutado PugetBench 1.0.7 con Photoshop 27.11 (2026) para ARM, utilizando el preset Standard. El resultado ha sido de 12.314 puntos, completando toda la prueba en 11,8 minutos.

Los 12.314 puntos reflejan el rendimiento conjunto del equipo en Photoshop; sin el desglose, no podemos identificar qué operaciones le cuestan más, ya que algunas dependen especialmente del rendimiento de la CPU, mientras que otras pueden aprovechar la aceleración gráfica o verse condicionadas por la memoria y el almacenamiento.
Por tanto, la puntuación representa el comportamiento conjunto del equipo trabajando con Photoshop, y no únicamente la potencia de uno de sus componentes.
Videojuegos
Después de las pruebas de creación de contenido e inteligencia artificial, tocaba comprobar qué tal se defiende el ProArt P16 jugando. Hemos utilizado Control Resonant y Cyberpunk 2077, en resolución nativa (2880 x 1800), probando distintas configuraciones para ver hasta dónde podemos subir los ajustes sin sacrificar demasiado la fluidez.
En Control Resonant, con los gráficos en alto, DLSS en Calidad y sin generación de fotogramas ni ray tracing, nos movemos alrededor de los 40 FPS. Activar el trazado de rayos en alto baja el rendimiento hasta unos 25 FPS, así que aquí tenemos que tocar los ajustes para jugar con comodidad.
La combinación que mejor nos ha funcionado es DLSS Rendimiento y generación de fotogramas, manteniendo los gráficos y el ray tracing en alto. Con ella alcanzamos unos 60 FPS y podemos jugar con una fluidez muy buena, sin cortes ni saltos perceptibles durante la partida. Estamos utilizando un reescalado más agresivo y fotogramas generados, pero el resultado en pantalla nos ha dejado satisfechos.
Al quitar el cargador, esta misma configuración baja hasta unos 50 FPS. Perdemos diez fotogramas por segundo, aproximadamente un 16,7 %, pero seguimos pudiendo jugar sin tener que renunciar al ray tracing. Un resultado asombroso que demuestra que NVIDIA no mentía cuando hablaba de rendimiento similar con y sin cargador.
Por otro lado, en Cyberpunk 2077 hemos utilizado el benchmark integrado. El preset Ray Tracing Medio, tal como viene configurado por defecto, consigue unos 32 FPS. Activando la generación de fotogramas dentro de ese mismo perfil subimos hasta aproximadamente 40 FPS. La mejora se agradece, aunque seguimos por debajo de los sesenta.
Si preferimos priorizar el rendimiento, el preset Ultra sin ray tracing alcanza unos 49 FPS. De las configuraciones probadas en Cyberpunk, es la que ofrece la mayor tasa de imágenes por segundo. Luego, ya depende de lo que queramos jugar con los ajustes. Podemos activar a mano un DLSS rendimiento, con generación de frames, y trazado de rayos medios con calidad media/alta, y podremos acercarnos mucho a los 60 FPS.
En batería observamos una pérdida proporcional similar a la de Control. El benchmark nos ha dado en torno a 26 FPS en RT Medio, 31 FPS con generación de fotogramas y 38 FPS en Ultra sin RT.
| Juego | Calidad gráfica | Ray tracing | DLSS | Generación de fotogramas | Conectado (FPS aprox.) | Batería (FPS aprox.) |
|---|---|---|---|---|---|---|
| Control Resonant | Alto | Desactivado | Calidad | Desactivada | 40 | 32 |
| Control Resonant | Alto | Alto | Calidad | Desactivada | 25 | 18 |
| Control Resonant | Alto | Alto | Rendimiento | Activada | 60 | 50 |
| Cyberpunk 2077 | Preset Ray Tracing Medio | Medio | Según preset | Desactivada | 32 | 26 |
| Cyberpunk 2077 | Preset Ray Tracing Medio | Medio | Según preset | Activada | 40 | 31 |
| Cyberpunk 2077 | Preset Ultra | Desactivado | Según preset | Según preset | 49 | 38 |
Durante las sesiones hemos visto una utilización de GPU del 90 – 95 %, con temperaturas entre 70 y 75 °C. En estas condiciones, el ProArt P16 nos permite disfrutar de ambos juegos, aunque conviene dedicar unos minutos a los ajustes. En Control nos quedamos con la combinación de DLSS y generación de fotogramas para mantener el RT alto; en Cyberpunk, el modo Ultra sin trazado de rayos nos ofrece el mejor rendimiento de los perfiles que hemos probado.
Pruebas en batería
Para terminar nuestras pruebas, queríamos comprobar qué tal se comporta el ASUS ProArt P16 cuando lo utilizamos lejos del enchufe. Y es que, por mucha potencia que tenga un portátil, de poco sirve si tenemos que estar constantemente pendientes del cargador.
Este equipo incorpora una batería de 99,9 Wh, una capacidad bastante generosa para un portátil de 16 pulgadas. Además, la arquitectura ARM del NVIDIA N1X debería jugar a su favor en tareas que no necesitan aprovechar toda la potencia del procesador y la GPU.
Para comprobarlo, hemos realizado una prueba bastante sencilla, pero representativa de un uso multimedia habitual: reproducir vídeo de YouTube en resolución 4K durante seis horas seguidas, utilizando únicamente la batería.
El resultado nos ha sorprendido gratamente. Después de esas seis horas de reproducción, el portátil todavía conservaba un 50 % de batería. Si hacemos una extrapolación sencilla, estaríamos hablando de unas 12 horas de autonomía reproduciendo vídeo 4K en YouTube.
También podemos hacernos una idea del consumo: teniendo en cuenta la capacidad nominal de 99,9 Wh, gastar la mitad de la batería en seis horas equivale aproximadamente a un consumo medio de 8,3 W. Es un cálculo orientativo, ya que el porcentaje mostrado por Windows no es una medición directa de la energía consumida, pero sirve para poner el resultado en perspectiva.
Hay que tener en cuenta, eso sí, que esta prueba representa un escenario multimedia y no el uso del portátil a plena potencia. Cuando trabajamos con modelos de inteligencia artificial, renderizamos escenas complejas o ejecutamos videojuegos, el consumo será considerablemente mayor y la autonomía se reducirá. Por ejemplo, cuando lo hacemos con un juego, como el Cyberpunk, la cosa cambia bastante. Con el preset RT Alto y Frame Gen activado, y el ordenador cargado al 100%, hemos podido jugar sin ningún problema durante una hora y 20 minutos. Llegado ese punto, Windows ya avisó de que la batería estaba en un estado crítico, y aunque podríamos haber alargado igual otros 10-15 minutos, decidimos cortar ahí y considerar que, dependiendo del juego, este procesador RTX SPARK nos puede dar entre una hora y una hora y media de batería en gaming. Nada mal.
En gaming también podemos hacernos una idea del consumo. Si tomamos los 99,9 Wh de capacidad nominal y los dividimos entre una hora y veinte minutos, obtenemos unos 75 W de consumo medio estimado para el portátil completo. Como detuvimos la prueba al aparecer el aviso de batería crítica, todavía quedaba algo de carga, por lo que el promedio real sería algo inferior. Es una aproximación al consumo jugando con batería, no una medición del consumo máximo del equipo ni del procesador por separado.
Aun así, nos parece un resultado muy digno. Estamos hablando de un portátil de 16 pulgadas, con una pantalla OLED y una GPU Blackwell, que ha sido capaz de reproducir contenido 4K durante seis horas consumiendo solamente la mitad de su batería.
En tareas multimedia, al menos, el NVIDIA N1X ha demostrado que puede ofrecer una autonomía muy competitiva sin renunciar a las prestaciones que hemos visto en las pruebas anteriores.
Conclusión: NVIDIA vuelve a revolucionar la informática con su N1X «Spark»
Después de probar el ASUS ProArt P16 con NVIDIA RTX Spark N1X, nos quedamos con la sensación de que lo más interesante de este equipo aparece cuando empezamos a combinar creación de contenido e inteligencia artificial local. Hemos podido editar con Photoshop, renderizar con OptiX, generar imágenes y ejecutar modelos de lenguaje de hasta 32B. Son trabajos distintos, y poder abordarlos en el mismo portátil es uno de sus principales atractivos.
Los 64 GB de memoria unificada tienen bastante que ver con ello. Nos dan margen para trabajar con modelos que resultarían difíciles de alojar íntegramente en muchas GPU de portátil con menos memoria dedicada. Eso sí, capacidad y velocidad son cosas diferentes: Qwen3 8B genera alrededor de 48,8 tokens por segundo, mientras que con Qwen3 32B nos situamos en unos 14 tokens por segundo. Podemos utilizar ambos, pero la diferencia de ritmo se nota.
También hemos comprobado que el contexto importa. Al pasar de 4096 a 32.768 tokens de profundidad en llama-bench, la generación del modelo 8B baja de 44,45 a 26,13 tokens por segundo. Por tanto, valorar un equipo para IA requiere mirar algo más que si consigue cargar el modelo: la longitud de los documentos y las conversaciones que vayamos a manejar también condicionan la experiencia. En generación de imágenes, Flux2 Dev NVFP4 ha completado nuestro workflow de 1024 × 1024 y veinte pasos con una mediana de 41,42 segundos, mientras que la nueva tanda de Klein 4B se queda en 14,58 segundos.
La parte creativa también nos deja resultados concretos: 12.314 puntos en PugetBench para Photoshop y renders completados mediante Cycles y OptiX.
Y sí, también hemos podido jugar. En Control Resonant alcanzamos unos 60 FPS con gráficos y ray tracing en alto, utilizando DLSS Rendimiento y generación de fotogramas. Al desconectar el cargador conservamos unos 50 FPS, una caída contenida para esa configuración. Cyberpunk 2077 exige ajustar algo más nuestras expectativas: conseguimos unos 49 FPS en Ultra sin RT, frente a los 32 FPS del preset RT Medio. El ProArt tiene recursos para disfrutar de estos juegos, aunque los resultados dependen mucho de las opciones elegidas.
Durante las sesiones de juego observamos temperaturas de 70–75 °C. Ser capaz de mantener buena parte del rendimiento al desenchufar es positivo, pero el tiempo de uso cae en picado, ya que en 1 hora hemos perdido un 60-65% jugando.
Otro de sus hándicaps es el precio. Hablamos de que el modelo más básico parte desde los 3500 euros, hasta más de 6000 en el modelo más completo con 128 GB de memoria RAM y 2 TB de SSD. Nuestro ASUS ProArt analizado cuesta en torno a los 4500 euros.
Por todo lo que hemos visto, nuestra valoración es favorable a lo que propone la plataforma, pero la recomendación de compra queda condicionada por el precio de la configuración. Lo que sí tenemos claro es dónde está su mayor interés: en llevar modelos de lenguaje, generación de imágenes, gaming y creación de contenido al mismo equipo, con resultados útiles más allá de una demostración.
Por todo ello, hemos dado a este ASUS ProArt P16, y al nuevo chip de NVIDIA SPARK N1X nuestro galardón de platino, destacando, por supuesto, su rendimiento.

